 Équipe Figwise
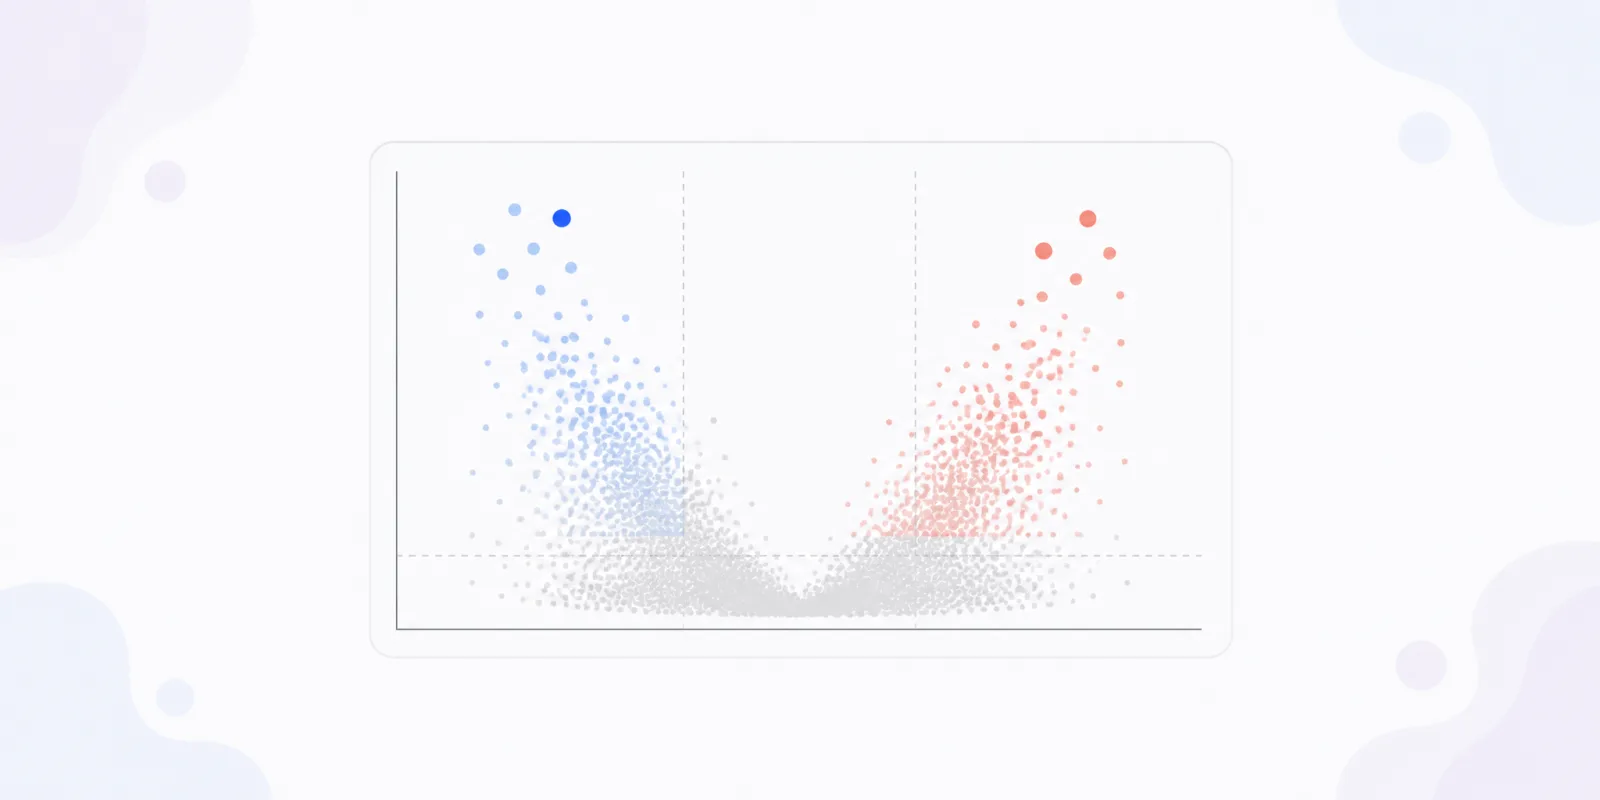
Un volcano plot place chaque gène issu d’un test d’expression différentielle sur un seul panneau. L’axe des x représente le log2 fold change. L’axe des y représente −log10 de la valeur p ajustée. Les gènes éloignés du centre et situés haut sont vos candidats.
Le volcano plot tient en dix lignes de code. Le lire correctement demande davantage d’attention. Les deux lignes en pointillés que la plupart des gens recopient, |log2FC| ≥ 1 et padj < 0.05, relèvent d’une habitude d’affichage, pas d’une règle — et le guide utilisateur d’edgeR indique que l’utilisation de cette paire pour sélectionner des gènes « détruira généralement le contrôle du FDR » (section 2.14).
Cet article présente ce que signifie chaque axe, quelle ligne de seuil tracer et pourquoi, comment lire chaque région du nuage, ainsi que du code R et Python fonctionnel. Si vous avez seulement besoin du diagramme, notre volcano plot generator prend un tableau de résultats et renvoie un graphique annoté.
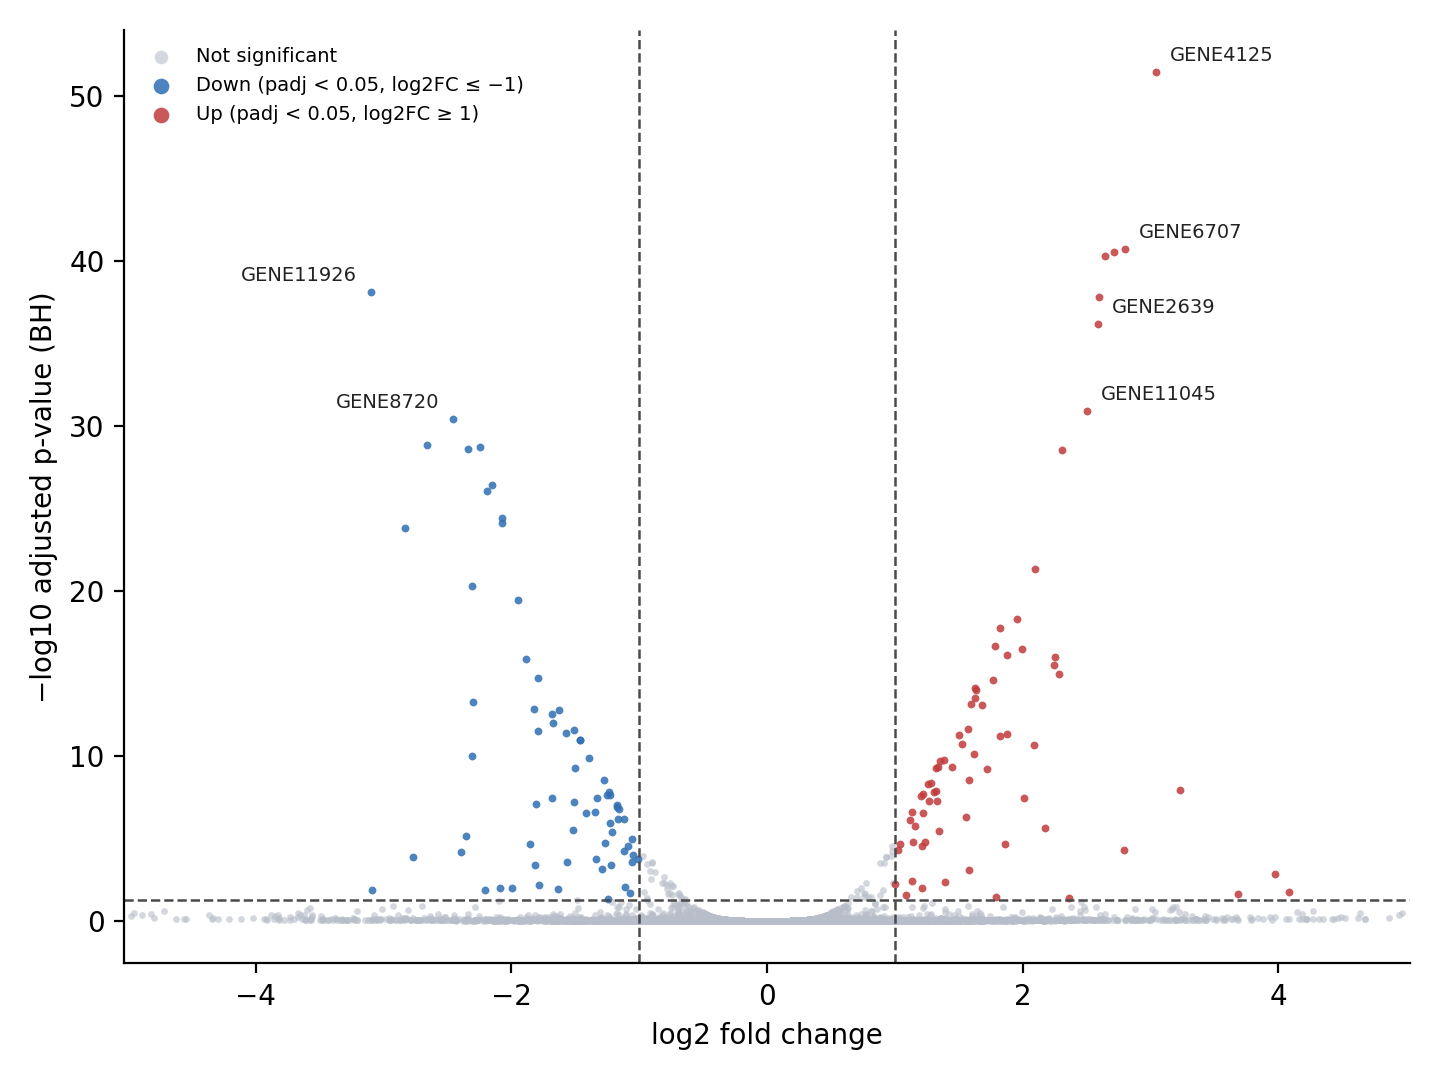
Volcano plot obtenu à partir de données simulées (12,000 gènes, 5% avec un effet réel). Réalisé avec matplotlib ; le code ayant généré les données se trouve dans la section Python ci-dessous, et le script complet de création du graphique se trouve à côté de cette image dans le dépôt.
Les deux axes et pourquoi ils sont tous deux en échelle logarithmique
Les deux axes sont en échelle logarithmique pour la même raison : les échelles brutes masquent la partie qui vous intéresse.
Le fold change sur une échelle brute est asymétrique. Un gène qui double vaut 2.0 et un gène qui est divisé par deux vaut 0.5 : la hausse peut aller jusqu’à l’infini, tandis que la baisse est comprimée sous 1. Le log2 corrige cela : un doublement devient +1, une division par deux devient −1, et les deux côtés du graphique sont en miroir.
Les valeurs p posent le problème inverse. Elles s’entassent près de zéro, là où se trouvent les résultats intéressants. Le −log10 étale cet amas, et le signe moins place les preuves les plus fortes en haut.
| padj | −log10(padj) | Position |
|---|---|---|
| 0.05 | 1.3 | la ligne en pointillés habituelle |
| 0.01 | 2.0 | juste au-dessus |
| 1e-10 | 10 | nettement dans le cône |
| 1e-50 | 50 | près du plafond |
Deux faits découlent de ce tableau. Un point à y = 4 a un padj cent fois inférieur à celui d’un point à y = 2. Et l’axe y n’a pas de borne supérieure : un gène doté d’une valeur p minuscule peut étirer tout le graphique.
Placez padj sur l’axe des y, pas la valeur p brute
Les valeurs p brutes sur l’axe des y vous donneront des centaines de faux résultats. Le RNA-seq bulk teste chaque gène, si bien qu’une analyse portant sur 15,000 gènes testés et sans effet réel donne tout de même environ 750 gènes à p < 0.05.
La solution est une correction du taux de fausses découvertes. La méthode de Benjamini-Hochberg rééchelonne les valeurs p afin qu’un seuil de 0.05 signifie « environ 5% des gènes que je conserve sont faux », et non « 5% de tous les tests ». R le fait dans p.adjust avec method = "BH", conformément à Benjamini et Hochberg (1995).
Les deux outils principaux fournissent déjà la colonne corrigée :
- DESeq2 (vignette) :
log2FoldChange,pvalue,padj. La colonnepadjest calculée selon BH par défaut, carresults()s’exécute avecpAdjustMethod = "BH". - edgeR (guide utilisateur) :
topTags()renvoielogFC,logCPM, une colonne de statistique de test (FouLR),PValueetFDR.FDRest la colonne à utiliser.
Deux détails de DESeq2 posent souvent problème ici. Tout d’abord, results() utilise alpha = 0.1 par défaut, et son étape de filtrage indépendant est optimisée pour cette valeur. Si votre ligne en pointillés est à 0.05, appelez results(dds, alpha = 0.05) afin que le filtrage corresponde à la ligne tracée.
Ensuite, certains gènes reviennent avec padj = NA. Il s’agit du filtrage indépendant et du retrait des valeurs aberrantes à l’œuvre, comme l’explique la section « Pourquoi certaines valeurs p sont-elles définies sur NA ? » de la vignette. Supprimez ces lignes avant de tracer. Ne remplacez jamais NA par 1 ou 0.
Où tracer les lignes de seuil
Il n’existe pas de paire de seuils standard, seulement des paires courantes. Voici l’origine réelle des valeurs populaires :
| Paire de seuils | Source | Convient lorsque |
|---|---|---|
| padj < 0.05, |log2FC| ≥ 1 (2-fold) | convention, aucune source primaire | de nombreux gènes différentiellement exprimés, bonne réplication |
| FDR < 0.01, |log2FC| ≥ 0.58 (1.5-fold) | tutoriel de formation Galaxy | signal fort, seuil plus strict sur la p que sur l’amplitude |
FDR < 0.05, fold change supérieur à 1.2, testé avec glmTreat |
guide utilisateur d’edgeR, section 4.4 | des milliers de résultats à réduire |
| padj < 0.1, aucune ligne de fold change | valeur alpha par défaut de DESeq2 |
petit n, criblage exploratoire |
Choisissez en fonction de la quantité de signal, pas de l’habitude. Si 6,000 gènes passent, la liste est inutilisable et une barre de fold change plus élevée aide. Si neuf gènes passent, supprimez la ligne de fold change et classez-les plutôt selon padj.
Le guide edgeR donne la meilleure règle en une ligne pour le seuil en x. Lisez-la comme « le fold change en dessous duquel nous ne sommes certainement pas intéressés par le gène », et non comme la variation au-dessus de laquelle un gène devient intéressant.
Le piège des seuils à connaître
Filtrer selon la valeur p puis selon le fold change n’est pas un test valide. Le guide edgeR est sans détour : de telles combinaisons « sont à la fois ad hoc et ne fournissent pas de valeurs p pertinentes pour tester une expression différentielle par rapport à un seuil de fold change ». Elles « favorisent les gènes faiblement exprimés mais très variables » et « détruisent généralement le contrôle du FDR ».
Si la barre de fold change compte pour votre conclusion, testez ce seuil plutôt que de filtrer après coup :
# DESeq2: test whether |log2FC| is above 1, not just above 0
res <- results(dds, lfcThreshold = 1, altHypothesis = "greaterAbs", alpha = 0.05)

# edgeR: same idea, via the TREAT method
fit <- glmQLFit(y, design)
tr  <- glmTreat(fit, coef = 2, lfc = 1)
À présent, padj tient déjà compte du seuil de taille de l’effet, et les lignes verticales décrivent le test effectué. Les deux options sont documentées : consultez les tests du log2 fold change au-dessus ou au-dessous d’un seuil dans DESeq2 et l’article sur TREAT à l’origine de glmTreat.
Comment lire le graphique, région par région
Lisez le nuage avant de lire les étiquettes. Sa forme en dit davantage sur l’expérience que n’importe quel gène isolé.
| Région | Ce que cela signifie | Que faire |
|---|---|---|
| En haut à droite, en haut à gauche | Variation importante, forte preuve | votre liste de candidats |
| Zone centrale supérieure (y élevé, |log2FC| < 0.3) | Petite variation, mesurée avec grande précision | vérifier l’identité du gène |
| Extrémités inférieures (|log2FC| > 2, y près de 0) | Ratio élevé, faible niveau de preuve | ne pas poursuivre |
| Large bande plate, rien au-dessus de la ligne | Peu ou pas de signal | reprendre le contrôle qualité |
Zone centrale supérieure est la région que les lecteurs interprètent le plus souvent mal. Ces gènes sont généralement des gènes à grand nombre de comptes, pour lesquels l’erreur standard est faible, si bien que même une variation de 15% franchit le seuil de p. La variation est réelle, mais la pertinence d’une variation de 15% relève de la biologie, pas des statistiques. Un signe d’alerte : si des gènes de ménage ou ribosomiques se trouvent dans cette zone, soupçonnez un problème de normalisation ou de composition de la librairie, et non la biologie.
Extrémités inférieures sont l’image miroir. Un gène avec 4 comptes dans un groupe et 30 dans l’autre donne un log2 fold change énorme et presque aucun élément probant. Ces points élargissent l’axe des x et rendent l’histoire plus spectaculaire, et ils se répliquent rarement. La rétraction des fold changes corrige l’affichage : lfcShrink(dds, coef = 2, type = "apeglm") rapproche de zéro les gènes mal mesurés et laisse les gènes bien mesurés inchangés.
Deux contrôles de forme complètent la lecture :
- Symétrie. Un nuage déséquilibré, par exemple 900 à la hausse et 40 à la baisse, peut correspondre à une activation réelle. Il peut aussi provenir d’un changement de composition que la normalisation n’a pas absorbé. Examinez le graphique MA et les facteurs de taille avant de rédiger cette phrase.
- Largeur du V. Le vide autour de x = 0, avec des points qui montent sur les deux flancs, est attendu, car les variations plus importantes franchissent plus facilement le seuil de p. En revanche, un pic vertical dense à x = 0 signifie généralement que vous avez tracé les valeurs p brutes.
Créez-le en R à partir de résultats DESeq2
Ce code fonctionne sur un DESeqDataSet appelé dds et nécessite ggplot2, ggrepel et dplyr.
library(DESeq2)
library(ggplot2)
library(ggrepel)
library(dplyr)

lfc_cut  <- 1
padj_cut <- 0.05

# keep alpha equal to the line you draw, or filtering optimises for 0.1
res <- results(dds, alpha = padj_cut)

df <- as.data.frame(res)
df$gene <- rownames(df)
df <- df[!is.na(df$padj), ]
df$padj <- pmax(df$padj, .Machine$double.xmin)  # padj can underflow to 0

df$class <- "Not significant"
df$class[df$padj < padj_cut & df$log2FoldChange >=  lfc_cut] <- "Up"
df$class[df$padj < padj_cut & df$log2FoldChange <= -lfc_cut] <- "Down"

top <- df %>%
  filter(class != "Not significant") %>%
  arrange(padj) %>%
  slice_head(n = 10)

ggplot(df, aes(x = log2FoldChange, y = -log10(padj), colour = class)) +
  geom_point(size = 1, alpha = 0.7) +
  geom_hline(yintercept = -log10(padj_cut), linetype = "dashed") +
  geom_vline(xintercept = c(-lfc_cut, lfc_cut), linetype = "dashed") +
  geom_text_repel(
    data = top, aes(label = gene),
    colour = "black", size = 3, max.overlaps = Inf, show.legend = FALSE
  ) +
  scale_colour_manual(values = c(
    "Up" = "#c23b3b", "Down" = "#2f6fb2", "Not significant" = "#b8bec9"
  )) +
  coord_cartesian(xlim = c(-5, 5)) +
  labs(x = "log2 fold change", y = "-log10 padj", colour = NULL) +
  theme_classic()
Si vous partez d’edgeR, renommez deux colonnes et le reste du script fonctionne :
df <- topTags(qlf, n = Inf)$table
df$log2FoldChange <- df$logFC
df$padj <- df$FDR
Pour une version entièrement mise en forme avec des connecteurs et des encadrés de seuil ombrés, la vignette EnhancedVolcano mérite d’être consultée.
Créez-le en Python à partir d’un DataFrame pandas
Exportez la table DESeq2 au format CSV, puis exécutez ce code. Il utilise uniquement pandas, numpy et matplotlib.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# first column is the gene name; needs DESeq2's log2FoldChange and padj
df = pd.read_csv("deseq2_results.csv", index_col=0)
df = df.dropna(subset=["padj", "log2FoldChange"]).copy()

lfc_cut, padj_cut = 1.0, 0.05

# padj can underflow to 0, which makes -log10 infinite; clip it first
df["y"] = -np.log10(df["padj"].clip(lower=np.finfo(float).tiny))
df["cls"] = "not significant"
df.loc[(df["padj"] < padj_cut) & (df["log2FoldChange"] >= lfc_cut), "cls"] = "up"
df.loc[(df["padj"] < padj_cut) & (df["log2FoldChange"] <= -lfc_cut), "cls"] = "down"

colours = {"not significant": "#b8bec9", "down": "#2f6fb2", "up": "#c23b3b"}
fig, ax = plt.subplots(figsize=(7, 5), dpi=200)
for name, grp in df.groupby("cls"):
    ax.scatter(grp["log2FoldChange"], grp["y"], s=6, c=colours[name],
               label=name, alpha=0.7, linewidths=0)

ax.axhline(-np.log10(padj_cut), ls="--", lw=0.9, c="#444444")
for v in (-lfc_cut, lfc_cut):
    ax.axvline(v, ls="--", lw=0.9, c="#444444")

top = df[df["cls"] != "not significant"].nsmallest(10, "padj")
for gene, row in top.iterrows():
    ax.annotate(gene, (row["log2FoldChange"], row["y"]), xytext=(4, 4),
                textcoords="offset points", fontsize=7)

ax.set_xlabel("log2 fold change")
ax.set_ylabel("-log10 padj")
ax.set_xlim(-5, 5)
ax.legend(frameon=False, markerscale=2)
fig.tight_layout()
fig.savefig("volcano.png")
Si vous partez d’une sortie edgeR en Python, renommez d’abord logFC en log2FoldChange et FDR en padj.
Le code derrière le diagramme ci-dessus
Le diagramme d’exemple utilise des données simulées, et non un jeu de données réel. Le modèle est volontairement simple : les moyennes de base s’étalent sur quatre ordres de grandeur, 5% des gènes portent un effet réel et l’erreur standard augmente à mesure que la moyenne de base diminue. C’est ce dernier point qui crée les points à faible niveau de preuve aux extrémités.
import numpy as np
from math import erfc

rng = np.random.default_rng(11)
n = 12000

base_mean = 10 ** rng.uniform(0, 4.2, n)
true_lfc = np.where(rng.random(n) < 0.05, rng.normal(0, 1.1, n), 0.0)
se = np.sqrt(0.035 + 9.0 / base_mean)        # low-count genes get a larger standard error
lfc = true_lfc + rng.normal(0, se)
pval = np.array([erfc(abs(s) / np.sqrt(2)) for s in lfc / se])

# Benjamini-Hochberg, same as R's p.adjust(method = "BH")
order = np.argsort(pval)
ranked = pval[order] * n / np.arange(1, n + 1)
padj = np.empty(n)
padj[order] = np.clip(np.minimum.accumulate(ranked[::-1])[::-1], 0, 1)
padj[base_mean < 1.5] = np.nan                # stand-in for independent filtering
Cinq erreurs qui rendent un volcano plot trompeur
- Valeurs p brutes sur l’axe des y. Des centaines de gènes franchissent la ligne par hasard. Utilisez
padjouFDR, et indiquez lequel dans le libellé de l’axe. - Prendre la ligne de fold change pour une signification biologique. Une variation de 2 fois dans un facteur de transcription et dans une protéine structurale ne constitue pas une conclusion comparable. La ligne est un filtre, pas une preuve.
- Laisser des valeurs aberrantes étirer les axes. Un gène à log2FC = 12 aplatit tout le reste. Limitez l’affichage avec
coord_cartesian()ouset_xlim(), et signalez les points tronqués par des triangles au bord au lieu de les supprimer. - Colorer uniquement selon le fold change. Mettre en rouge chaque gène au-delà de x = 1 fait passer des gènes bruyants à faible nombre de comptes pour des résultats positifs. La couleur doit dépendre des deux conditions : au-delà de la ligne du fold change et au-delà de la ligne de padj.
- Aucune ligne en pointillés. Sans elles, le lecteur ne peut pas identifier votre seuil sur le graphique. Tracez les deux et indiquez les valeurs dans la légende ou la clé.
FAQ
Un volcano plot est-il identique à un graphique MA ?
Non, ils répondent à des questions différentes. Un graphique MA place l’expression moyenne sur l’axe des x et le log2 fold change sur l’axe des y, de sorte qu’il montre si vos grandes variations proviennent de gènes à faible nombre de comptes. Un volcano plot laisse de côté le niveau d’expression et montre plutôt le niveau de preuve. Produisez les deux pendant l’analyse, puis publiez le volcano plot.
Que faire lorsque padj vaut exactement 0 ?
Il s’agit d’un sous-flux en virgule flottante, pas d’une valeur p égale à zéro. -log10(0) donne l’infini et le point disparaît ou casse l’axe. Bornez padj au plus petit double positif avant le logarithme, comme dans le code Python ci-dessus, et indiquez le gène comme padj < 1e-300 dans le texte.
Combien de gènes dois-je annoter ?
Dix à vingt restent lisibles ; au-delà, c’est le désordre. Classez-les selon padj parmi les gènes qui franchissent aussi la ligne de fold change, puis annotez-en un nombre fixe. Utilisez ggrepel en R ou des appels annotate décalés en Python pour que le texte ne recouvre pas les points. Annotez tout gène cité dans le résumé, même s’il ne se trouve pas dans les dix premiers.
Un volcano plot peut-il être inséré directement dans un article ?
Oui, s’il est exporté en format vectoriel ou à la résolution demandée par la revue, et si l’analyse sous-jacente est reproductible. Les éditeurs traitent les diagrammes de données différemment des illustrations, et ces règles comptent avant la soumission — consultez notre guide sur les politiques des revues concernant les diagrammes générés par l’IA. Pour le panneau récapitulatif d’un article, un graphical abstract maker couvre la partie schématique, tandis que le volcano plot reste le graphique de vos propres nombres.