 Équipe Figwise
Le site officiel de PRISMA fournit le modèle. Il ne vous dit pas quoi inscrire dans chaque case ni pourquoi vos nombres refusent de concorder. Ce guide fait les deux.
Voici la version courte. Chaque case du diagramme de flux PRISMA 2020 contient un décompte issu de vos données de sélection. À chaque étape, le nombre inscrit doit être égal au nombre qui passe à l’étape suivante plus le nombre supprimé. Et depuis 2020, les cases finales comptent séparément les études et les rapports — le changement qui induit le plus d’auteurs en erreur.
Vous trouverez ci-dessous :
- Ce que signifie chaque case et d’où vient son nombre
- Les huit règles arithmétiques qui doivent être respectées, sous forme de liste d’auto-contrôle
- Un exemple complet, ainsi qu’un diagramme publié qui contient une erreur
- Le modèle officiel, le package R et un PRISMA flow diagram generator gratuit pour créer le diagramme à partir de vos nombres
Commencez par choisir le bon modèle
Il existe quatre modèles officiels, pas un seul. Les nouvelles revues et les revues mises à jour ont chacune leur propre version. Chaque version existe avec ou sans colonne supplémentaire pour les sources autres que les bases de données et les registres.
| Modèle | À utiliser quand |
|---|---|
| Nouvelle revue, bases de données et registres uniquement | La plupart des revues systématiques. Vous avez consulté des bases de données comme PubMed ou Embase, et peut-être des registres d’essais. |
| Nouvelle revue, avec d’autres sources | Vous avez également trouvé des références sur des sites web, auprès d’organisations ou par recherche de citations. Une deuxième colonne est ajoutée. |
| Revue mise à jour, bases de données et registres uniquement | Vous mettez à jour une revue publiée et devez présenter les anciennes et les nouvelles études. |
| Revue mise à jour, avec d’autres sources | Les deux situations ci-dessus. |
Les quatre sont des fichiers Word gratuits disponibles sur la page officielle du diagramme de flux PRISMA, sous licence CC BY 4.0. La suite de ce guide présente la version standard : nouvelle revue, bases de données et registres uniquement. La colonne « autres méthodes » suit la même logique, avec une particularité expliquée plus bas.
Page officielle de téléchargement du modèle sur prisma-statement.org, consultée le 23 août 2026.
Case par case : quel nombre inscrire où
Trois termes structurent tout le diagramme, et la déclaration PRISMA 2020 les définit précisément :
- Une référence est « le titre ou le résumé (ou les deux) d’un rapport indexé dans une base de données ou sur un site web. » Deux références renvoyant au même rapport sont des doublons ; celles qui renvoient à des rapports simplement similaires ne le sont pas.
- Un rapport est un document : un article, une prépublication ou une thèse.
- Une étude est une investigation, qui peut être décrite par plusieurs rapports.
Le haut du diagramme compte les références. La partie centrale compte les rapports. Le bas compte les études et les rapports.
Références identifiées
Saisissez le nombre brut issu de chaque export de recherche, avant la suppression des doublons. Les bases de données (PubMed, Embase, Scopus...) et les registres (ClinicalTrials.gov, ICTRP...) occupent des lignes distinctes. Votre source est le fichier d’exportation ou le nombre de « résultats » enregistré à la date de votre recherche.
La note de bas de page du modèle demande davantage de détails lorsque vous pouvez les fournir :
« Si possible, envisagez d’indiquer le nombre de références identifiées dans chaque base de données ou registre consulté (plutôt que le nombre total pour l’ensemble des bases de données/registres). »
Ainsi, « Bases de données (n = 644) » est acceptable, mais « PubMed (n = 312), Embase (n = 245)... » est préférable.
Références supprimées avant la sélection
Cette case comporte trois sous-lignes, chacune ayant un sens distinct :
- Doublons supprimés — le nombre indiqué par votre gestionnaire de références ou outil de sélection (EndNote, Zotero, Covidence, Rayyan) après dédoublonnage.
- Références signalées comme non éligibles par des outils d’automatisation — les références supprimées par un classificateur ou un filtre sans examen humain.
- Références supprimées pour d’autres raisons — tout autre élément supprimé avant la sélection, par exemple des références hors de vos limites de date qui seraient passées entre les mailles.
Zéro dans la plupart des revues ; écrivez n = 0 au lieu de supprimer la ligne.
Références examinées, références exclues
« Références examinées » désigne ce qui a été conservé pour la sélection des titres et résumés. Ce nombre doit être égal aux références identifiées moins tout ce qui a été supprimé avant la sélection. « Références exclues » désigne ce que les évaluateurs ont rejeté à cette étape. Aucun motif n’est requis ici — les motifs deviennent obligatoires au niveau inférieur.
Une note de bas de page s’applique si un logiciel vous a aidé :
« Si des outils d’automatisation ont été utilisés, indiquez combien de références ont été exclues par un humain et combien par des outils d’automatisation. »
Rapports recherchés pour récupération, rapports non récupérés
L’unité passe ici des références aux rapports : vous cherchez désormais à obtenir les textes intégraux. « Rapports recherchés pour récupération » correspond aux références examinées moins les références exclues. « Rapports non récupérés » compte les textes intégraux impossibles à obtenir — articles derrière un paywall sans accès via votre bibliothèque, résumés de conférences sans article, auteurs n’ayant jamais répondu.
Rapports évalués pour admissibilité, rapports exclus
La sélection porte sur le texte intégral. « Rapports évalués » correspond aux rapports recherchés moins les rapports non récupérés. La case des exclusions est le seul endroit où les motifs sont obligatoires, et chaque motif doit avoir son propre décompte :
- population inadéquate (n = ...)
- intervention inadéquate (n = ...)
- type d’étude inadéquat (n = ...)
Les décomptes par motif doivent totaliser le nombre total de rapports exclus.
Études incluses dans la revue, rapports des études incluses
La dernière case contient deux nombres, ce qui constitue le changement principal par rapport à PRISMA 2009. L’ancien diagramme se terminait par un seul décompte d’« études ». PRISMA 2020 vous demande de les séparer, car un même essai donne souvent lieu à plusieurs articles. Si 24 études ont été incluses et que 5 d’entre elles avaient un second article associé, écrivez : Études incluses dans la revue (n = 24) ; Rapports des études incluses (n = 29).
La colonne « autres méthodes », si nécessaire
La version 2 du modèle ajoute à droite une deuxième colonne pour les références trouvées sur des sites web, auprès d’organisations ou par recherche de citations. Elle comporte ses propres cases « recherchés », « non récupérés » et « évalués », ainsi qu’une case complète de Rapports exclus avec ses propres lignes de motifs. Elle n’a pas d’étape de sélection : il n’y a ni Références examinées ni Références exclues de ce côté. Les deux colonnes ne fusionnent que dans la dernière case des éléments inclus.
Faites concorder les nombres : règles d’équilibre
Le diagramme est une série de contrôles d’équilibre. Effectuez les huit contrôles avant toute exportation :
- Bases de données + registres = le total d’identification à partir duquel vous soustrayez
- Doublons + suppressions par automatisation + autres suppressions = tout ce qui a été supprimé avant la sélection
- Références identifiées − références supprimées avant la sélection = références examinées
- Références examinées − références exclues = rapports recherchés pour récupération
- Rapports recherchés − rapports non récupérés = rapports évalués pour admissibilité
- Rapports évalués − rapports exclus = rapports des études incluses
- Somme des motifs d’exclusion détaillés = total des rapports exclus
- Rapports des études incluses ≥ études incluses dans la revue
Les contrôles 1 et 2 sont nécessaires parce que le modèle officiel ne comporte aucune case de total : en haut, il affiche des lignes séparées pour les bases de données et les registres, et la case des suppressions comporte trois sous-lignes. Vous les additionnez vous-même, ce qui explique les premières erreurs.
Lorsqu’un contrôle échoue, la cause relève généralement de l’un de trois cas.
- Un écart dans le décompte des doublons. EndNote et Covidence comptent les doublons différemment ; prenez tous les nombres dans le journal d’un seul outil, plutôt que de les mélanger.
- Une confusion entre références et rapports. Une « référence exclue » au stade du résumé et un « rapport exclu » au stade du texte intégral sont deux événements différents. En déplacer un d’un niveau à l’autre fausse deux contrôles à la fois.
- Des articles associés. Si vous avez fusionné trois articles en une étude lors de l’extraction, le nombre d’études diminue, mais celui des rapports ne doit pas changer.
Un exemple détaillé avec les nombres renseignés
Le diagramme ci-dessous est un exemple détaillé, pas une vraie revue — les nombres sont les nôtres et ont été choisis pour montrer que chaque règle est respectée. Nous l’avons dessiné avec notre PRISMA flow diagram generator. Vous saisissez 13 nombres ; il crée le diagramme standard avec bases de données et registres, puis vous exportez en SVG ou PNG. Il est gratuit et fonctionne dans le navigateur, sans compte.
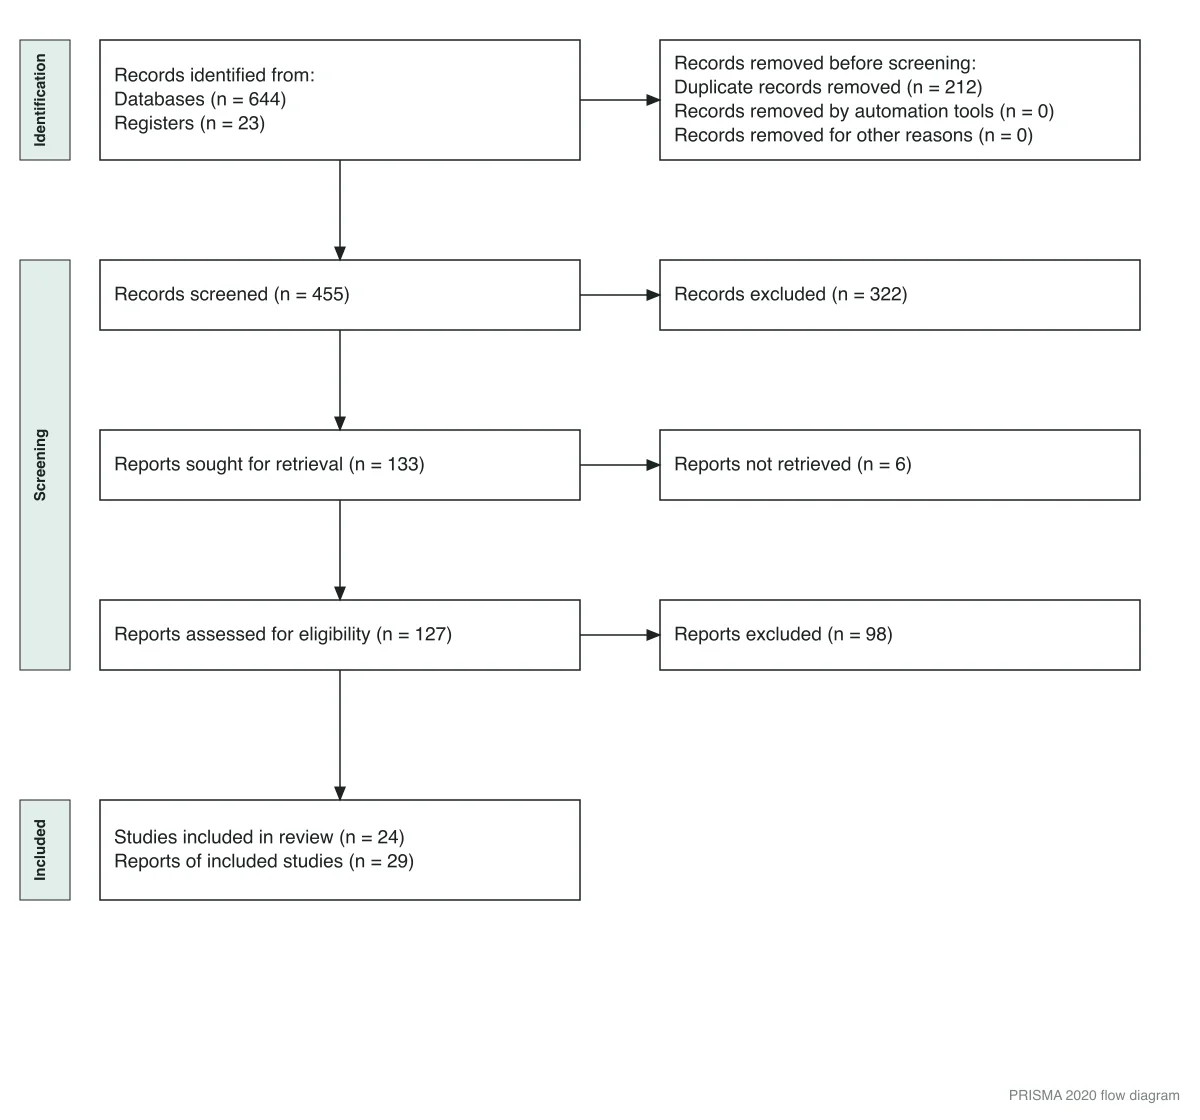
Exemple détaillé rendu avec le FigWise PRISMA generator. Chaque niveau est équilibré : 667 − 212 = 455 ; 455 − 322 = 133 ; 133 − 6 = 127 ; 127 − 98 = 29 rapports pour 24 études.
Suivez le calcul une fois : 644 références de bases de données plus 23 références de registres donnent 667. Supprimez 212 doublons et il en reste 455 pour la sélection. Les évaluateurs en excluent 322 ; 133 textes intégraux sont donc recherchés. 6 ne peuvent pas être récupérés, ce qui en laisse 127 à évaluer. L’évaluation du texte intégral en exclut 98, laissant 29 rapports décrivant 24 études.
Trois précisions importantes sur l’outil :
- Il couvre uniquement le modèle standard de nouvelle revue. Il n’existe ni colonne « autres méthodes » ni version de revue mise à jour ; utilisez le fichier Word officiel pour ces cas.
- Sa formulation est proche de celle du modèle officiel, mais pas identique — la ligne d’automatisation affiche « Records removed by automation tools » alors que le modèle indique « Records marked as ineligible by automation tools » — et il n’imprime ni l’en-tête de colonne ni les deux notes de bas de page précédées d’un astérisque citées plus haut. Si votre journal vérifie le diagramme par rapport au modèle, modifiez le texte SVG exporté.
- Sa case des exclusions ne contient qu’un total. Le SVG exporté contient un véritable texte modifiable, mais la case a une hauteur fixe et aucun retour à la ligne — ajouter trois ou quatre lignes de motifs fera déborder le texte de la bordure, à moins d’agrandir aussi la case. Pour une case d’exclusions détaillées, le modèle Word officiel demande moins de travail.
Même des diagrammes publiés se trompent
Les contrôles d’équilibre ne sont pas théoriques. Une revue systématique de 2026 publiée dans Frontiers in Dental Medicine (DOI: 10.3389/fdmed.2026.1720637) montre à quel point un diagramme publié peut s’écarter de son propre texte.
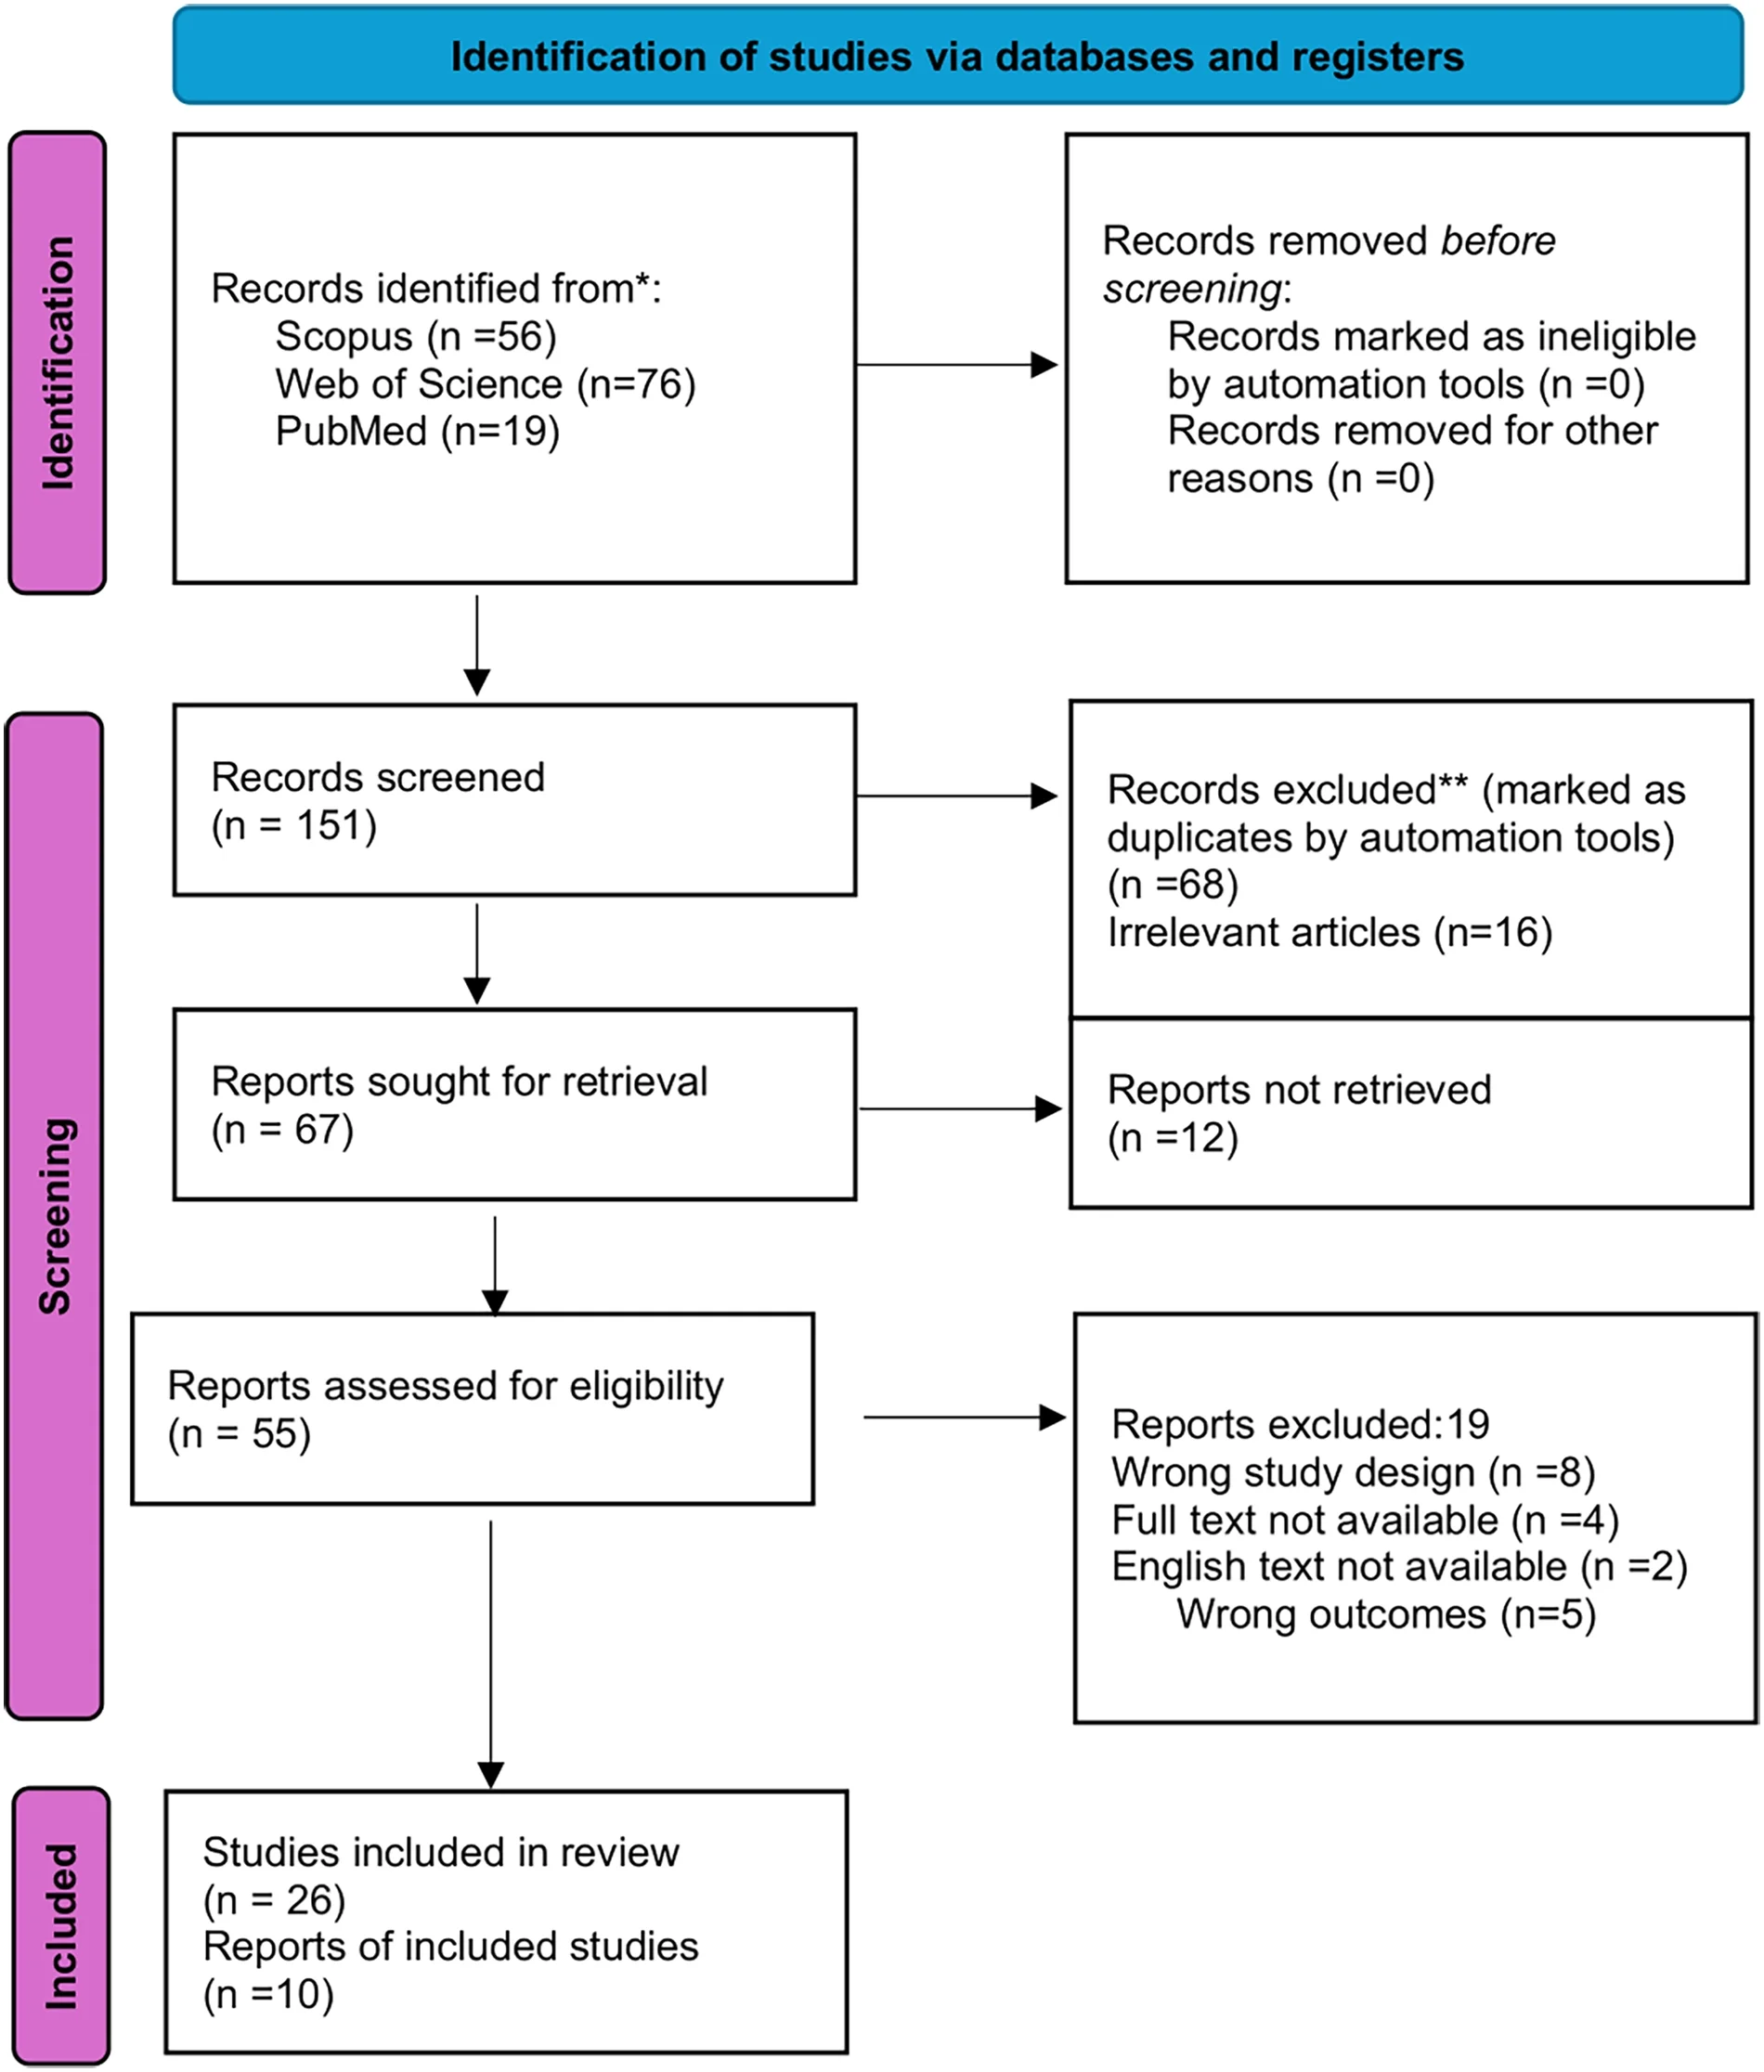
Diagramme 1 de Harikrishna et al., Frontiers in Dental Medicine, 2026, reproduit sans modification sous CC BY 4.0. Comparez ses décomptes au texte de l’article et aux contrôles d’équilibre ci-dessus.
Trois incohérences sont visibles :
- Le diagramme étiquette le total brut de 151 comme « Références examinées ». Il déplace ensuite la suppression des doublons dans la case d’exclusion au stade de la sélection, où le modèle place les exclusions liées au sujet.
- Les décomptes de suppression du diagramme sont de 68 doublons et 16 éléments non pertinents ; le texte indique que « 65 doublons ont été supprimés par des outils d’automatisation et 19 références ont été exclues parce qu’elles étaient clairement non pertinentes ». Les deux totalisent 84, et 151 − 84 = 67 correspond à la case suivante dans chaque version ; les totaux concordent donc et seule la répartition diffère.
- La case
Références supprimées avant la sélectionindique l’automatisation (n = 0) et les autres raisons (n = 0), la ligneDoublons supprimésayant été supprimée au lieu de recevoir un nombre. Voilà l’élément de la liste de contrôle qui apparaît trois lignes plus bas, cette fois dans un article publié. - La dernière case indique 26 études issues de 10 rapports, alors que le texte précise que « 36 études remplissaient les critères d’admissibilité ». Les rapports des études incluses ne peuvent jamais être moins nombreux que les études. Le texte explique l’origine de 26 et 10 : « 10 études CFD fournissaient des données extractibles de contrainte de cisaillement pariétal spécifiques aux aiguilles… Les 26 autres études incluses apportaient des informations contextuelles. » Les deux cases contiennent donc une répartition des 36 selon le type de données, et non un décompte d’études et de rapports.
Rien de tout cela ne modifie les résultats de la revue. Cela montre que le diagramme peut être vérifié et que les évaluateurs le vérifient.
Erreurs courantes : la liste de contrôle finale
Avant la soumission, vérifiez chaque ligne :
- Les cases supérieures contiennent les décomptes bruts des exports, avant dédoublonnage
- Les registres ont leur propre ligne, sans être intégrés aux bases de données
- Chaque sous-ligne vide indique n = 0 au lieu d’être supprimée
- Les doublons figurent dans « supprimés avant la sélection », pas dans les exclusions de sélection
- Les motifs d’exclusion du texte intégral sont détaillés et totalisent le nombre total d’exclusions
- Rapports des études incluses ≥ études incluses dans la revue
- Les huit contrôles d’équilibre sont respectés
- Les nombres du diagramme correspondent à ceux de votre résumé et du texte des résultats
Outils : modèle, package R, application Shiny et ce site
Quatre options couvrent la plupart des situations :
- Modèles Word officiels — la formulation de référence, à privilégier lorsque votre journal veut un fichier modifiable ou si vous avez besoin des mises en page pour autres méthodes ou revues mises à jour.
- Package R PRISMA2020 — adapté aux pipelines reproductibles ; le diagramme est recréé à partir d’un fichier de données lorsque les nombres changent. Le code source est disponible sur GitHub, et la méthode est décrite dans un article en libre accès par Haddaway et ses collègues.
- L’application Shiny — le même moteur avec une interface de formulaire, sans R. Elle fonctionne sur le niveau gratuit de shinyapps.io, sans garantie de disponibilité ; le package local est la solution de secours.
- FigWise PRISMA flow diagram generator — l’option la plus rapide pour le diagramme standard : saisissez 13 nombres, observez la prévisualisation en direct, exportez en SVG ou PNG. Pour la présentation des résultats d’essais randomisés, la même approche s’applique dans notre CONSORT flow diagram generator.
Si un autre diagramme de votre manuscrit provient d’un outil d’IA, vérifiez ce que les éditeurs autorisent réellement — les règles diffèrent fortement et les diagrammes de flux ne sont pas traités comme des images de données.
FAQ
Ai-je encore besoin du diagramme si ma recherche a trouvé très peu d’études ?
Oui, en pratique. Le point 16a vous demande de « [d]écrire les résultats de la recherche et du processus de sélection, depuis le nombre de références identifiées lors de la recherche jusqu’au nombre d’études incluses dans la revue, idéalement à l’aide d’un diagramme de flux. » Notez idéalement — le point peut être satisfait en prose. Cependant, les revues qui adhèrent à PRISMA attendent le diagramme, que vous ayez examiné 90 références ou 9,000.
Qu’est-ce qu’un registre, et que faire si je n’en ai pas consulté ?
Les registres sont des registres prospectifs d’études, tels que ClinicalTrials.gov ou l’ICTRP de l’OMS. Si vous n’en avez consulté aucun, écrivez Registres (n = 0) ou supprimez cette ligne — mais indiquez-le dans vos méthodes, car de nombreux journaux attendent une recherche dans les registres pour les revues d’essais.
Puis-je utiliser le diagramme PRISMA 2009 à la place ?
Non. La déclaration PRISMA 2020 précise qu’elle « remplace la déclaration PRISMA 2009, qui ne doit plus être utilisée ». L’ancien diagramme se termine également par un seul décompte d’« études incluses » ; il ne peut donc pas montrer la distinction entre études et rapports.
D’où viennent les motifs d’exclusion ?
Ils proviennent de votre journal de sélection du texte intégral. Des outils comme Covidence et Rayyan exportent un motif par rapport. Regroupez-les en une courte liste — population inadéquate, intervention inadéquate, type d’étude inadéquat, résultat inadéquat — et veillez à ce que les décomptes totalisent le nombre total.