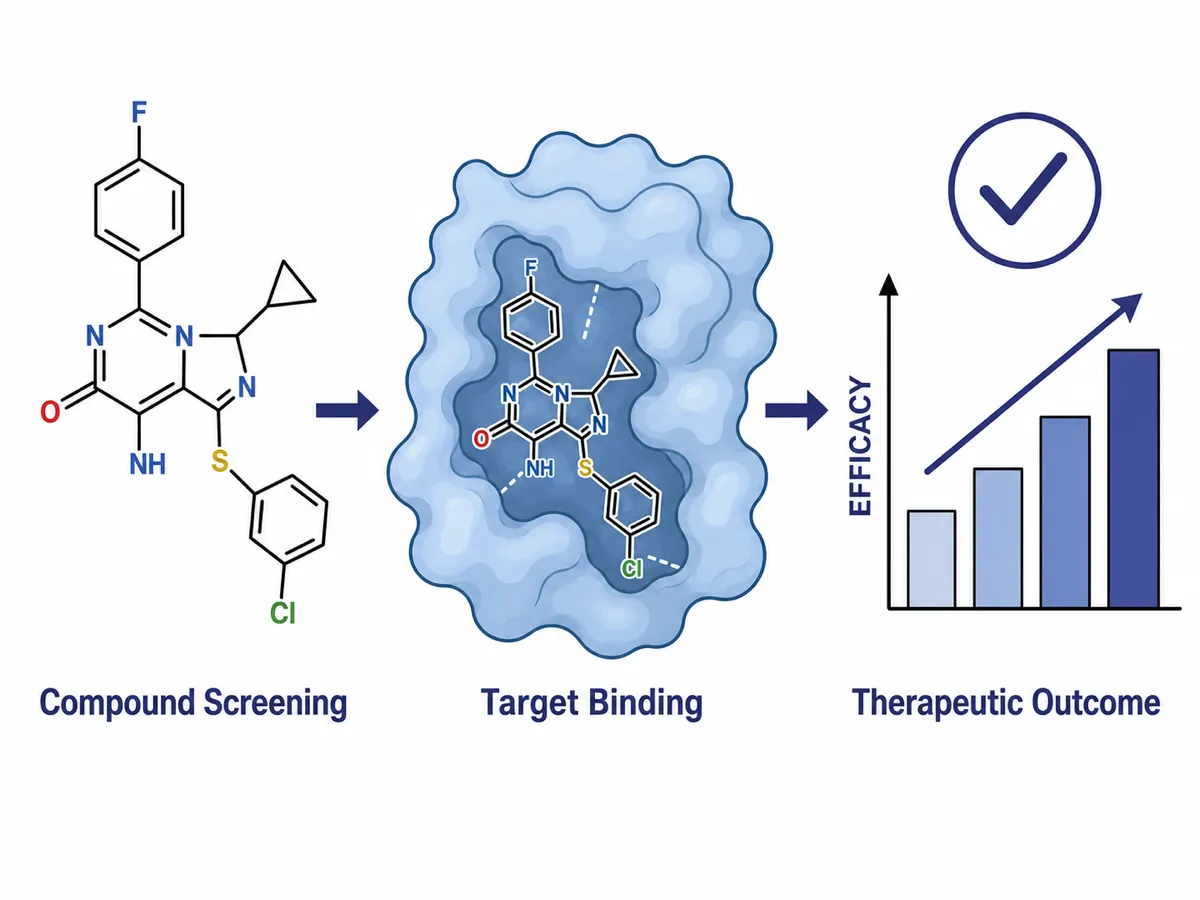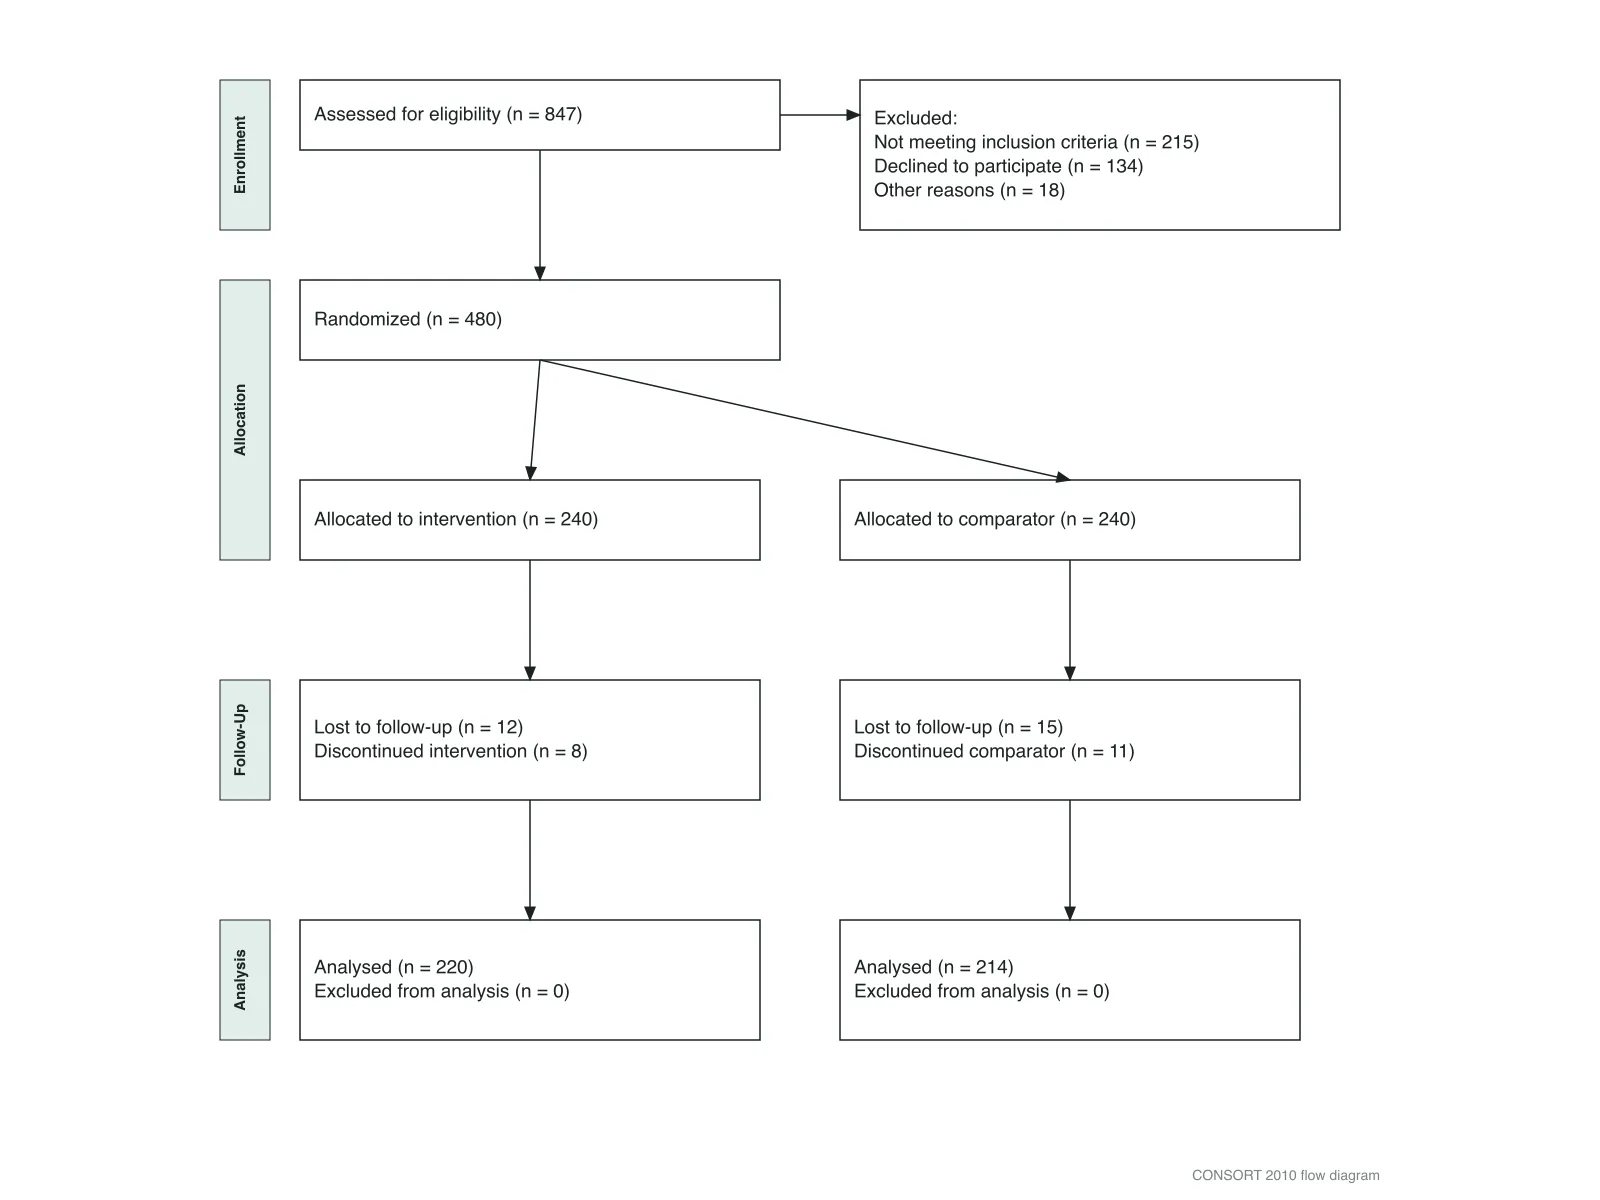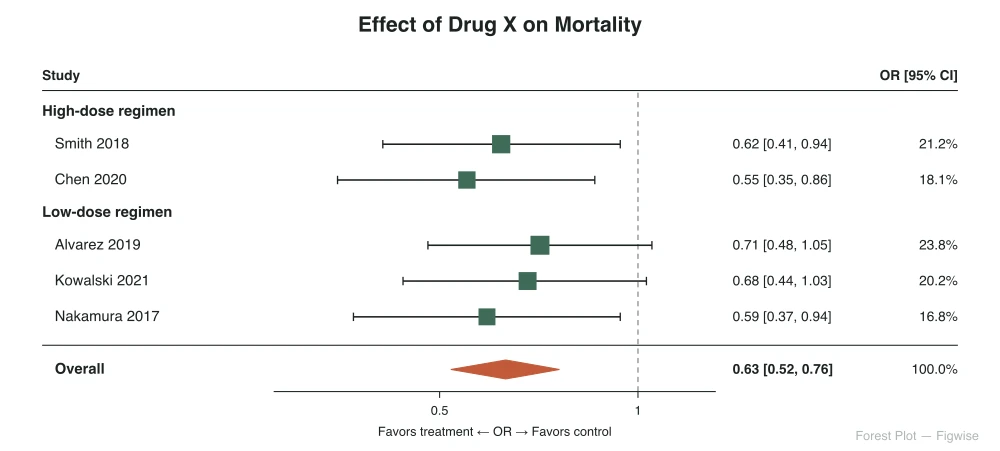
粘贴论文摘要,AI 生成三栏式视觉摘要——方法、结果、结论各一栏,图标与关键数字直接渲染在图内。
视觉摘要是把论文的方法、结果、结论压缩进一张图的摘要形式,几秒钟就能看完——为期刊社媒账号而生,长段文字在信息流里很容易被划走。
外科与临床期刊常用的版式是三栏结构:方法一栏、结果一栏、结论一栏,每栏配一个图标式插图、一行简短标签,以及一个直接取自摘要的关键数字——样本量、百分比或风险比。
它不能替代正文摘要,而是一张辅助图,让编辑、审稿人与读者在决定是否深入阅读之前,先看到论文最核心的发现。
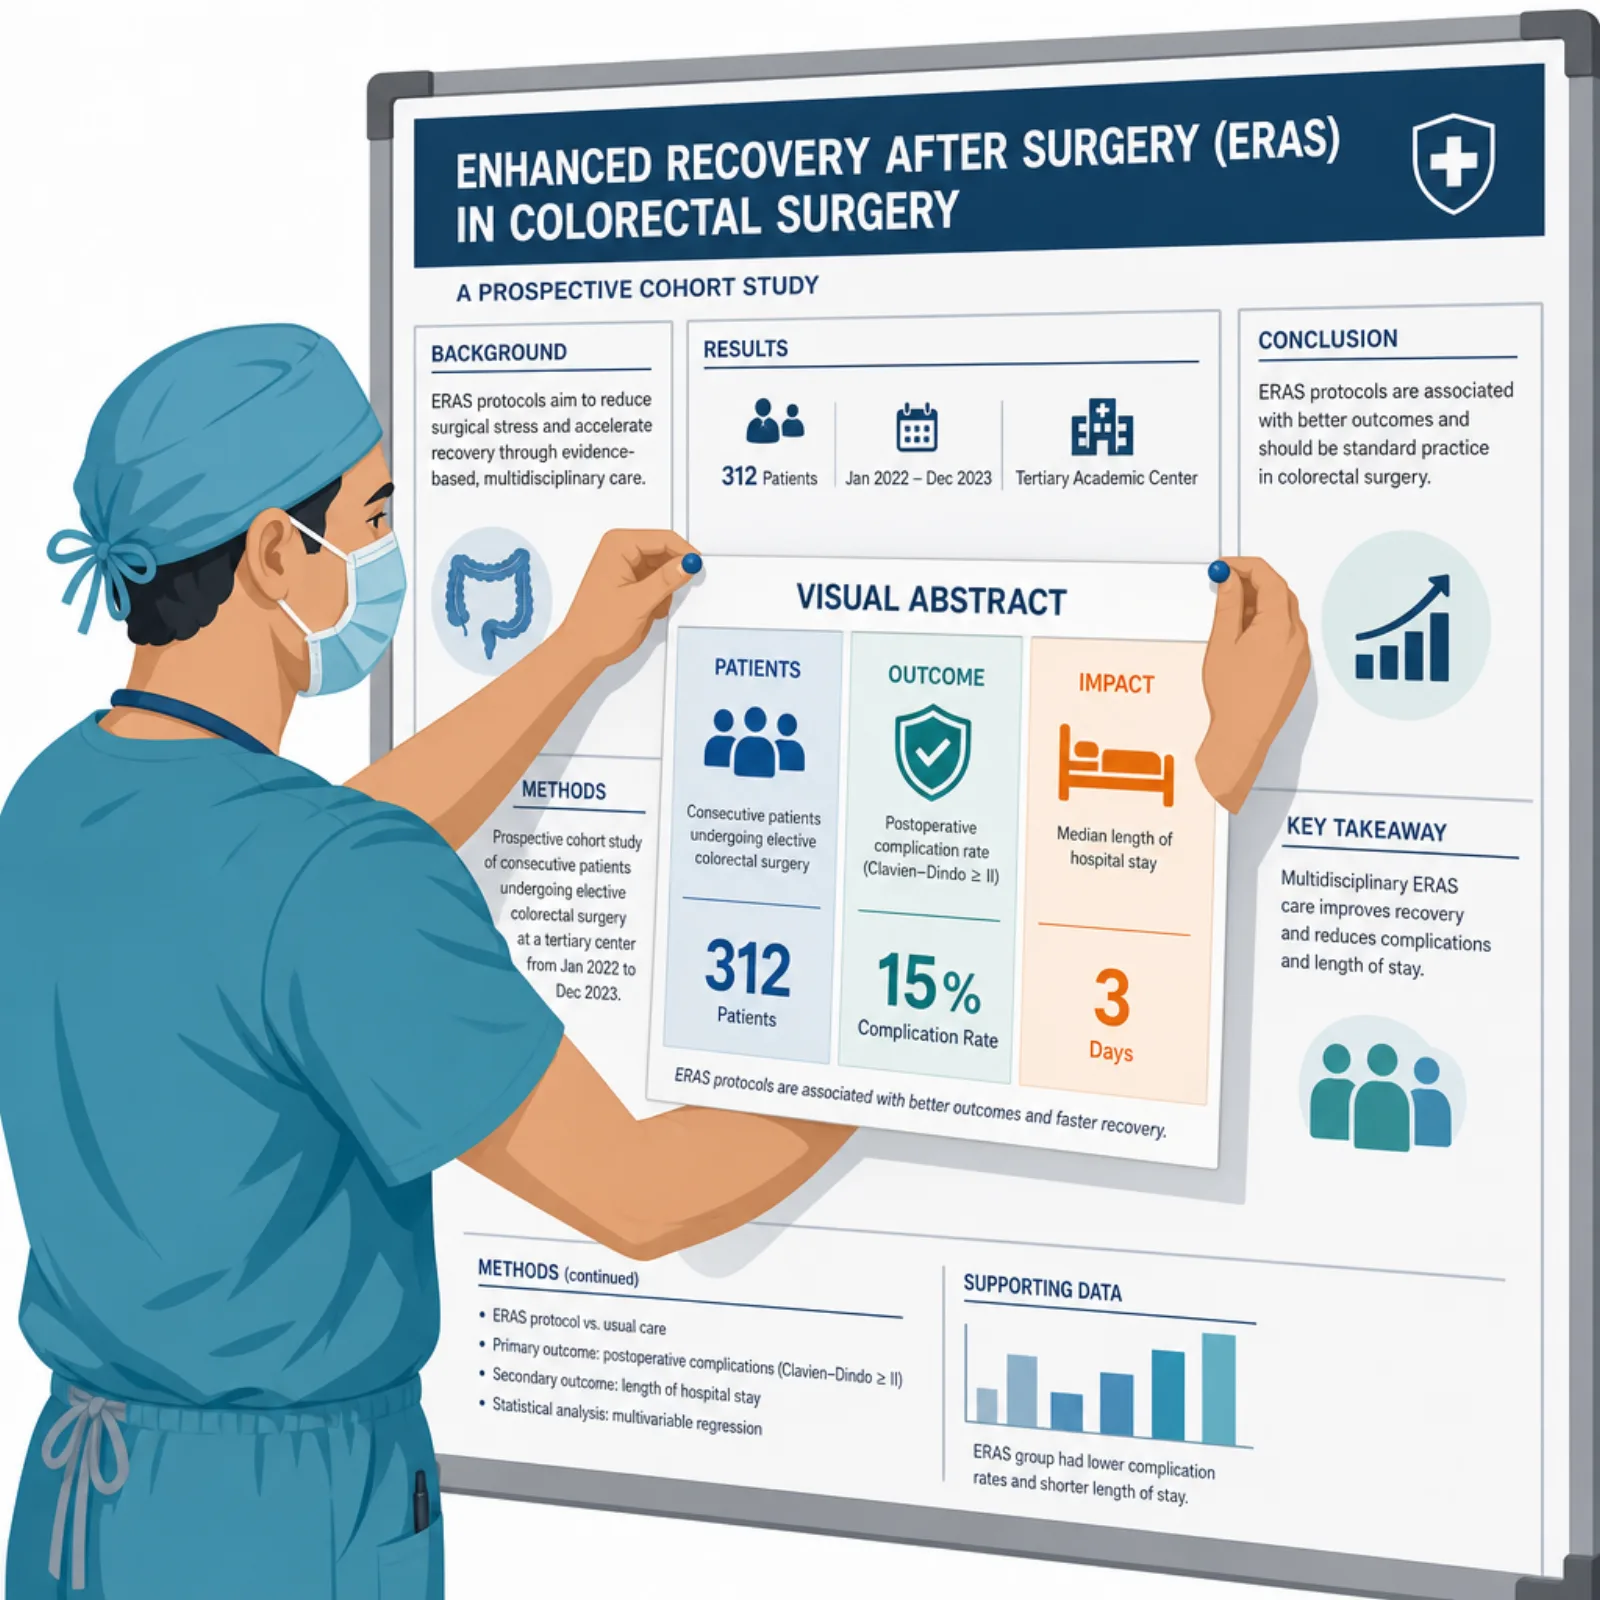
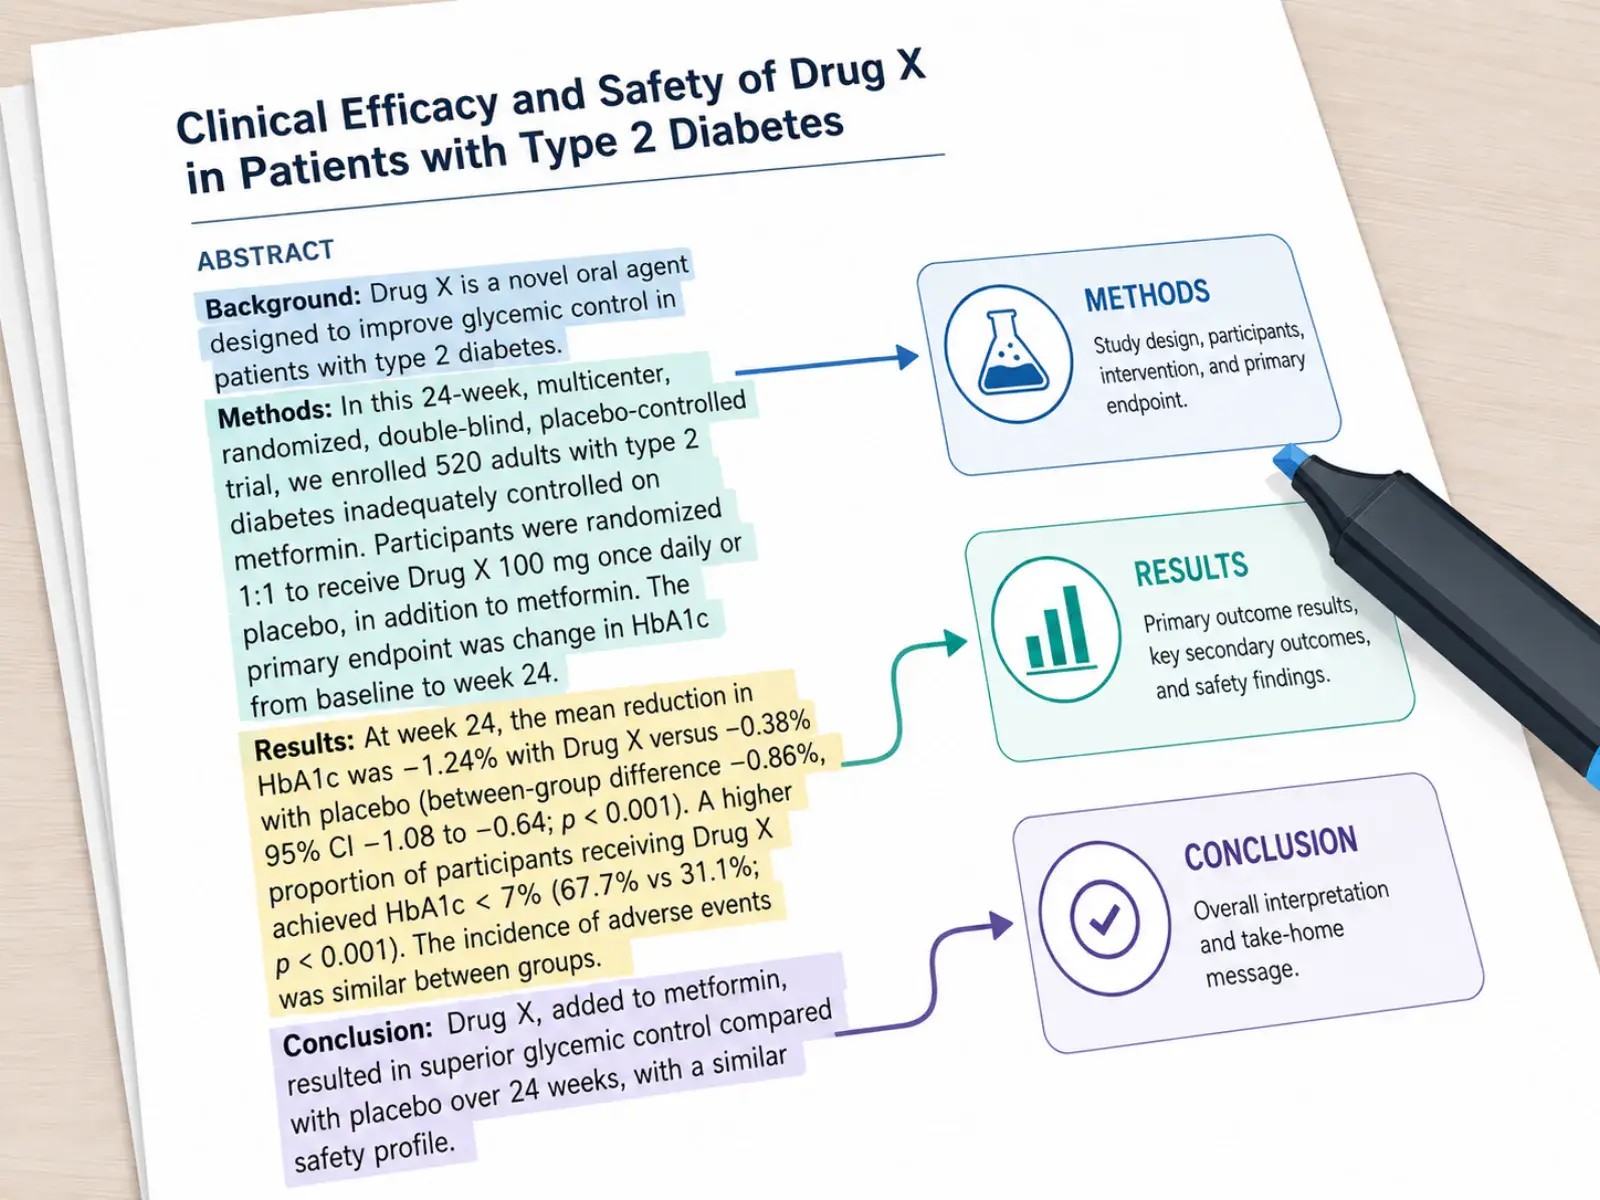
粘贴摘要后,生成器按方法学角色对每句话分类,再排入对应的一栏——不用自己截图拼图,也不用手动裁剪已发表的图表。
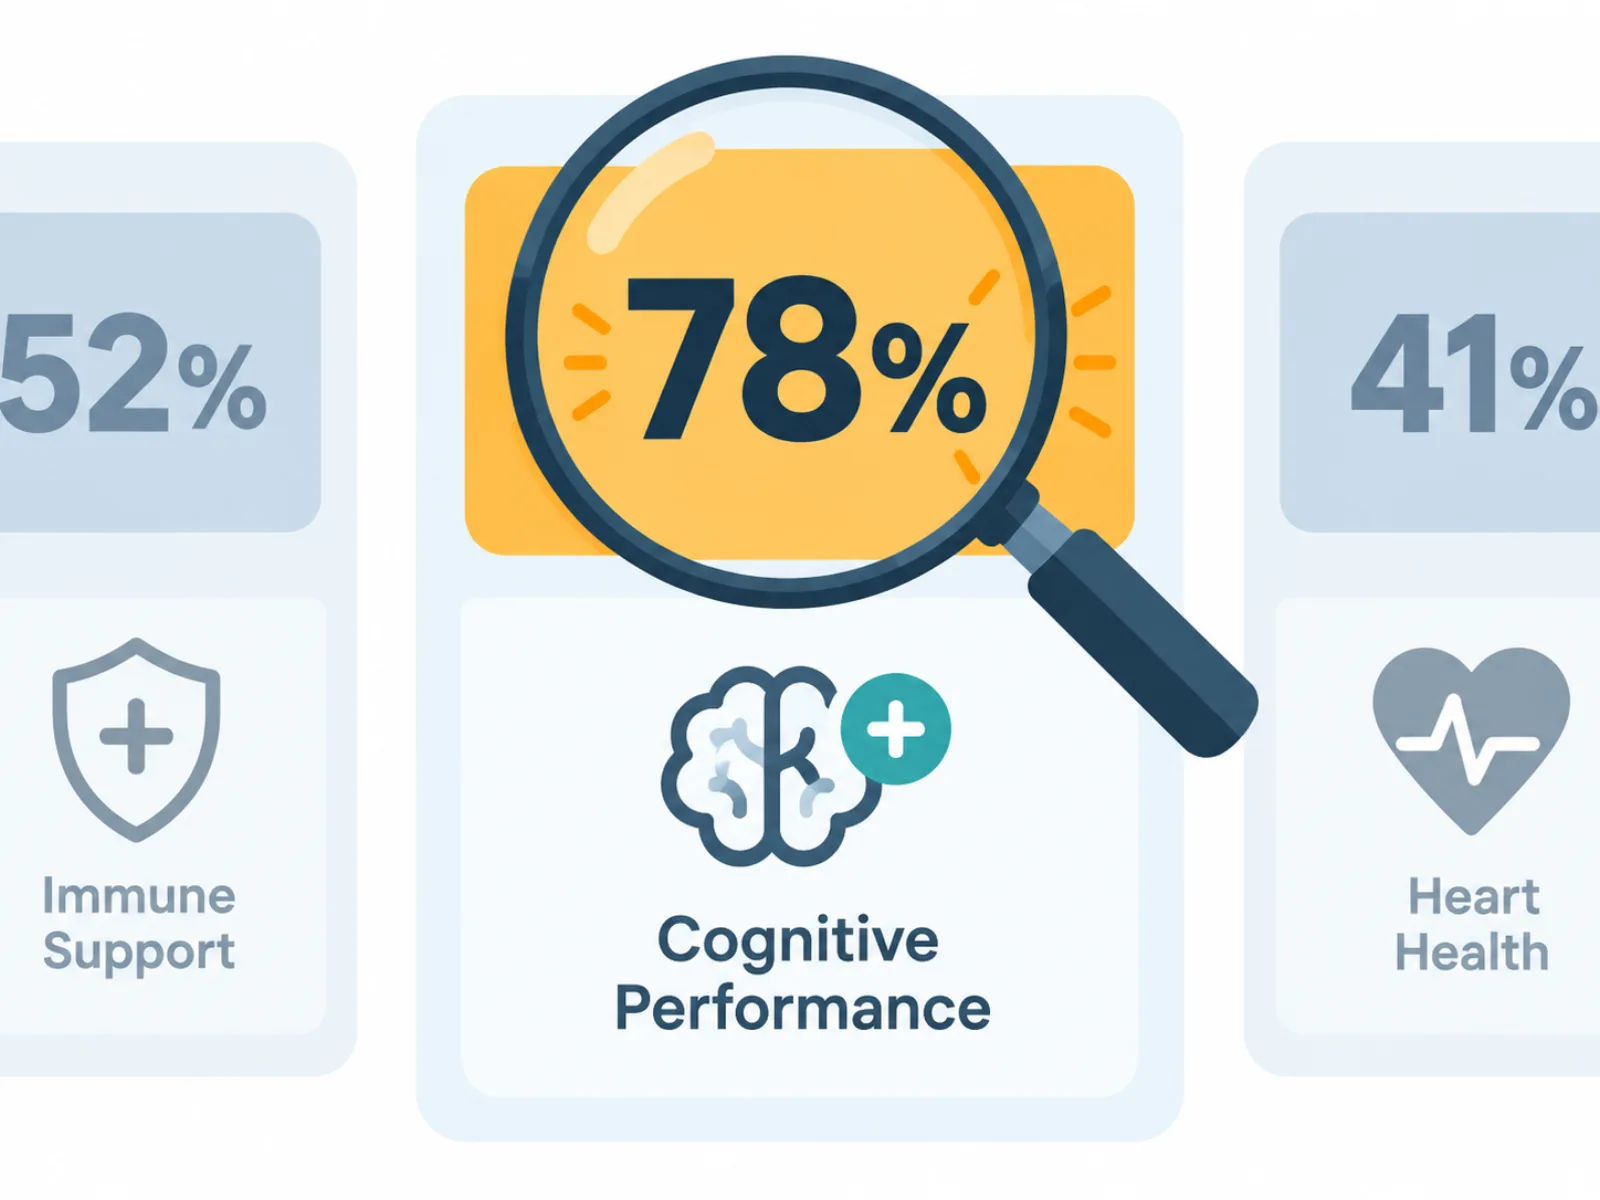
样本量、百分点变化、风险比——生成器从每一栏提取一个具体数字并以大号加粗字体渲染,即使缩成社媒信息流里的缩略图也依然清晰可读。
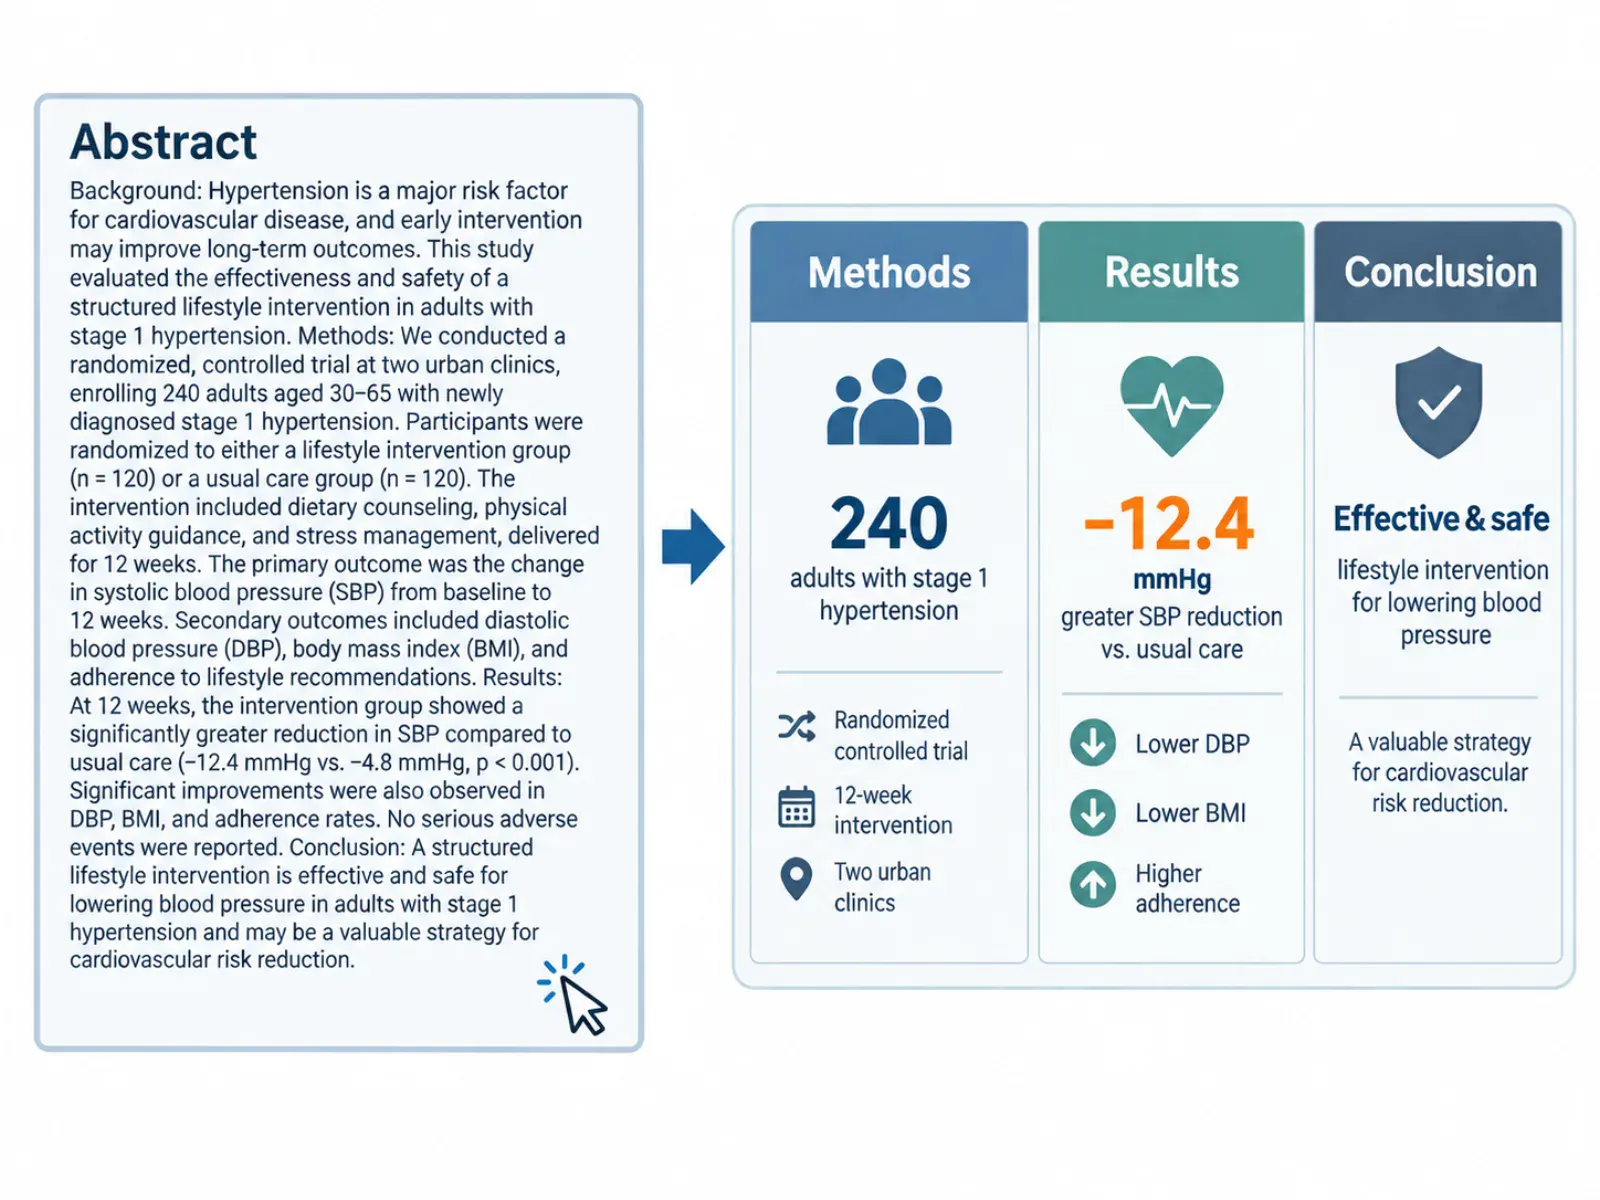
不用学任何绘图工具。按论文里原本的样子粘贴摘要,生成器会推断出图标、标签与版式——尺寸适配期刊配图或社媒帖子。
两个词经常被混用,但它们是版式、起源与期刊要求都不同的两种摘要图。
固定三栏:方法 · 结果 · 结论
面板数量不固定,从背景讲到发现
四个起点,覆盖临床试验、公共卫生、外科与护理——每一栏都带着摘要里的真实数字。
一项在 412 名 2 型糖尿病成人患者中开展的 GLP-1 受体激动剂试验,HbA1c 下降幅度与达标率作为关键数字渲染在图内。
一项覆盖 28,600 名女性的 AI 辅助乳腺钼靶阅片队列研究,检出敏感度与召回率作为关键数字渲染在图内。
一项对比腹腔镜与开腹阑尾切除术的 950 例患者队列研究,住院时长与感染率作为关键数字渲染在图内。
一项覆盖 6,200 次住院的护士主导跌倒预防干预研究,跌倒率下降幅度作为关键数字渲染在图内。
从粘贴摘要到下载三栏式成图,只需三步。
从你的稿件或预印本里复制摘要——就是你会投给期刊的那段文字。
生成器把文字归入方法、结果、结论三栏,并为每一栏提取一个关键数字。
确认每个渲染出的数字都与摘要一致,再下载图片用于投稿或实验室社媒账号。
* 当前导出高分辨率 PNG。
动手做之前,先回答这些关于版式与期刊要求的问题。
* 当前导出高分辨率 PNG。
粘贴一次摘要,即可获得三栏式视觉摘要——注册即送免费试用积分。