 Figwise 团队
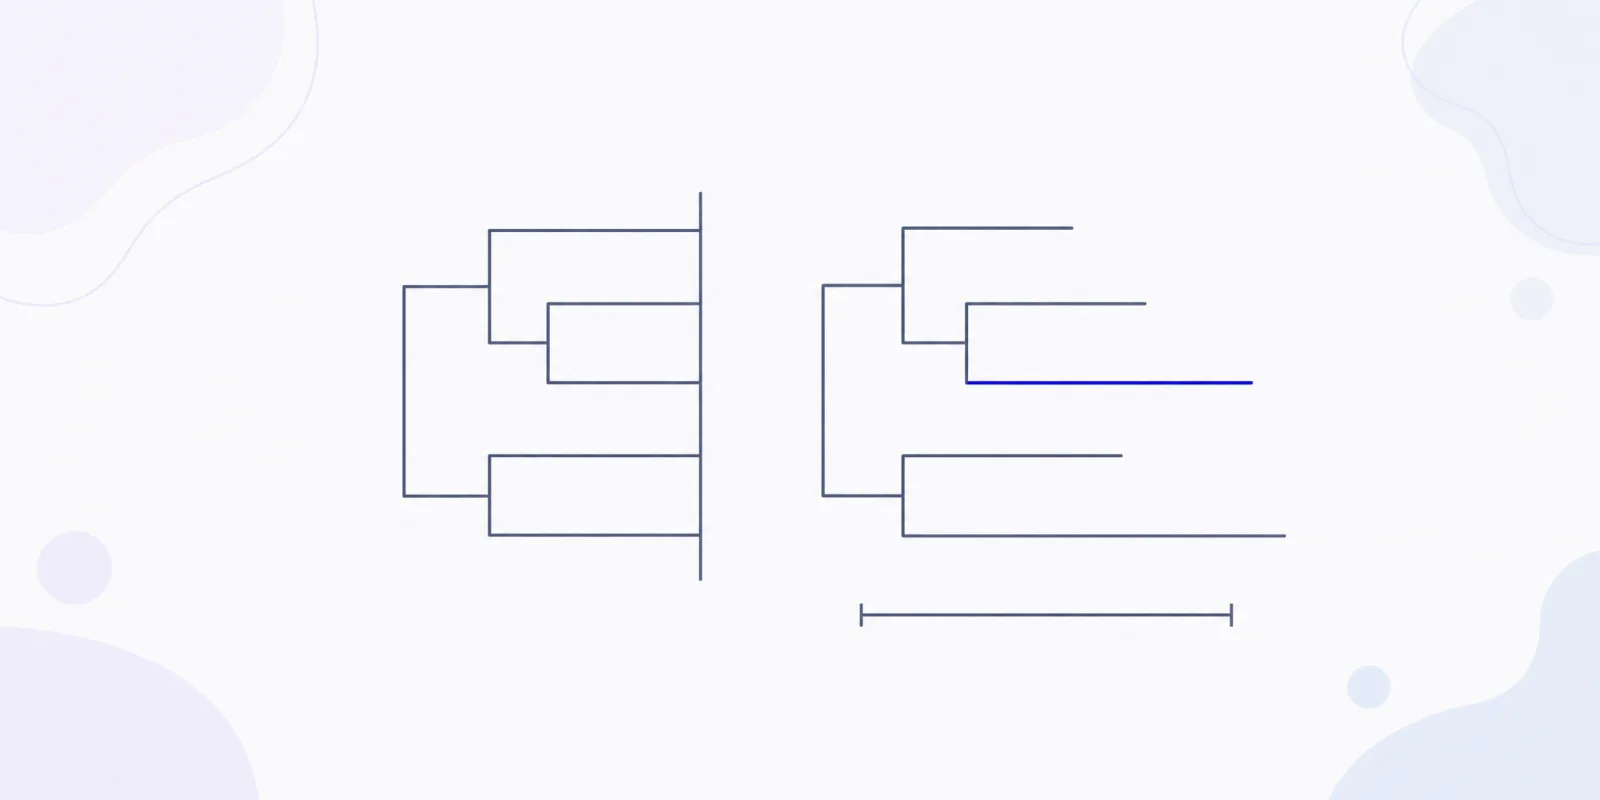
分支图和系统发育树可以画出完全相同的分支模式。差别在分支本身。分支图的分支长度不携带任何信息;带标度的树上,分支长度是数据——要么是遗传变化量,要么是时间。
这一条规则决定了你能从一张图里读出什么。多数讲这个话题的页面到此为止,其中还有几个把后面讲错了:它们说分支图来自形态性状、系统发育树来自 DNA。两者都可以由任一种数据建成。
下面是真正有用的部分:三步判断手上这张图是哪一种,四步把它读下来,以及在考试答案和论文草稿里最常出现的六种误读。
一条规则概括差别
分支长度要么有意义,要么没有。其余一切都由此推出。
| 分支图(cladogram) | 支长树(phylogram) | 时间树(chronogram) | |
|---|---|---|---|
| 分支长度 | 无意义 | 变化量 | 经历的时间 |
| 标尺条或坐标轴 | 没有 | "0.05 substitutions per site" | "Ma"、"Myr"、年 |
| 末端 | 全部对齐在一条线上 | 参差不齐 | 样本都取自当下则对齐,样本带采样日期则错开 |
| 你能主张什么 | 只有分支顺序 | 顺序 + 变化量 | 顺序 + 年代 |
T. Ryan Gregory 的开放获取入门文章把分支图这条规则说得很直接:"分支图上各分支的长度完全不传递任何信息。"相比之下,支长树的分支长度"与某种分歧度量成正比",而且"通常带一条标尺条"。
注意这个来源把什么算作分歧:DNA 序列的比较或形态特征的比较。所以数据类型不是分界线。
一棵基于骨骼测量的简约法树可以是支长树。一棵来自全基因组的树也可以画成光秃秃的分支图。决定性的是画图的人有没有给分支加标度。
三步判断手上这张图是哪一种
按顺序做。十秒钟,你就知道这张图有资格告诉你什么。
- 找标尺条或坐标轴。 一小段标着
0.05的线段表示每个位点的替换数。坐标轴写 Ma 或 Myr 表示时间。既没有标尺条也没有坐标轴?就当分支图看,别对"多少"下任何结论。 - 看末端。 末端参差不齐,说明分支按某个量缩放过——标尺条写的是替换数就是变化量,坐标轴写的是年份就是时间。末端对齐既可能是分支图,也可能是一棵全为现存样本的时间树,所以还得靠第 1 步区分这两者。
- 读图注里的方法行。 "Maximum likelihood, GTR+G, 1000 bootstrap replicates" 描述的是一棵有真实分支长度的树。"Strict consensus of 12 equally parsimonious trees" 通常意味着你看到的只是拓扑。
第 2 步最容易翻车,而且两个方向都会翻。末端对齐给人"没有长度信息"的感觉,但只含现存物种的时间树末端也是对齐的,因为每个样本都取自当下。反过来,末端参差也不一定就是支长树:用化石定标的树、以及采样日期不同的树,末端会按时间错开。真正定性的是标尺——每位点替换数,还是年份。
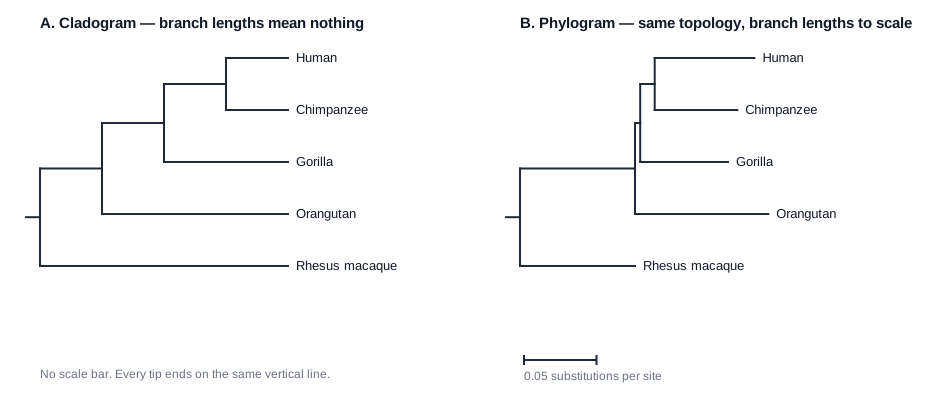
同一个拓扑,两种画法。两个面板出自同一棵邻接法树,是我为这篇文章用五个 RefSeq 线粒体基因组的细胞色素 b 编码序列算出来的:人(NC_012920.1)、黑猩猩(NC_001643.1)、大猩猩(NC_011120.1)、猩猩(NC_002083.1)、恒河猴(NC_005943.1)。距离经 Jukes-Cantor 校正;根放在恒河猴分支的中点。
带标度的分支到底在数什么
支长树的单位通常是每位点替换数。0.05 的标尺条代表每一百个比对位点上大约五处变化。要得到两个末端之间的总分歧量,把从一个末端下行到共同祖先、再上行到另一个末端这条路径上的每一段分支加起来。
在真实图上做这个加法前有两点要留意。下面表格里的百分比是未校正的原始差异,而图上画出的分支经过 Jukes-Cantor 校正,两者对不上。另外这里的根落在猴那条支的中点上,所以那条支在图上被劈成了两半。
下面是上图背后的真实数字。细胞色素 b 基因在这五种灵长类里都是 1,141 个碱基,不存在需要处理的插入缺失:
| 物种对 | 差异位点数(共 1,141) | 百分比 |
|---|---|---|
| 人 vs 黑猩猩 | 132 | 11.6% |
| 人 vs 大猩猩 | 142 | 12.5% |
| 黑猩猩 vs 大猩猩 | 137 | 12.0% |
| 人 vs 恒河猴 | 241 | 21.1% |
从这张表里能读出两件事。人和黑猩猩是最近的一对,与公认的分支顺序一致。
以及,面板 B 里人的分支(0.069)比黑猩猩的分支(0.057)长,说明这个基因在分化之后于我们这一侧积累了更多变化。这个结论只有支长树才支持得起。面板 A 拓扑完全相同,却撑不住它。
时间树反过来。它把年代放在节点上,把速率差异隐藏掉,所以你能读出"这两支大约在六百万年前分开",但读不出"这一支变化更快"。不同支系的速率并不相同,所以绝不要把支长树的分支长度当成经历的时间。
四步读完任何一棵树
1. 先找根,再找外群
根是图中最深的那一点,正是它把一团关系变成一段历史。给树定根靠的是外群:一个位于你关心的类群之外、但又近得能做序列比对的类群。Gregory 的入门文章指出,外群物种是"给一棵进化树定根所必需的"。
选那个明确落在你的类群之外、同时又最近的亲缘类群。太近,它其实属于内群;太远,它的长分支会把根拽到错误的位置。我这张图里,恒河猴对四种猿扮演的就是这个角色。
关于用词有一个提醒:通向外群的那条分支常被称作"基部(basal)",Gregory 建议别这么叫,因为读者会理解成原始或祖先。恒河猴不是那棵树上任何其他物种的祖先。它是一个现代物种,背后的历史一样长。
2. 把内部节点读成祖先,不是读成物种
每个内部节点是一个一分为二的祖先种群。它不等于它的任何一个后代。这类错误的经典版本:鲸和河马是姐妹群,但这不意味着鲸的祖先是河马。化石里的早期鲸类,比如 Pakicetus,长得和河马毫无相似之处。
同一套逻辑也回答了那个老掉牙的问题。人不是从黑猩猩演化来的。我们和它共用一个节点。
3. 认出姐妹群
两个末端在一个不含其他成员的节点上汇合时,它们就是姐妹群。图中人和黑猩猩是姐妹群。大猩猩是"人 + 黑猩猩"这整个类群的姐妹群,而不是其中任何一支的姐妹群。
把亲缘关系用节点的语言说出来,大部分混乱就消失了:共用节点更近的那一对,就是亲缘更近的那一对。伯克利 Understanding Evolution 把这条规则表述为"共同祖先是进化亲缘关系的货币"。
4. 在相信一个节点之前先看支持度
分支旁边的数字告诉你这条分支有多可重复,而不是它有多久或者有多正确。阈值取决于产出它的方法,而且彼此不能换算:
- 标准 bootstrap(BS) 偏保守。在超快 bootstrap 那篇论文里,标准 bootstrap 值 80% 就已经对应 0.95 的正确概率,作者也提到"支持度 80% 以上才采信"是被广泛接受的做法。更老更松的那条 70% 经验规则出自 Hillis 与 Bull 1993 年在 Systematic Biology 42:182–192 上的检验。
- 超快 bootstrap(UFBoot) 近乎无偏,所以同一条分支上它给出的数值更高。IQ-TREE FAQ 的说法是"只有支持度 >= 95% 才开始依赖一条分支",并提醒不要把 BS% 和 UFBoot% 直接比较。
- SH-aLRT 与 UFBoot 配对使用;同一页建议 80% 以上,并把 SH-aLRT ≥ 80% 且 UFBoot ≥ 95% 的分支视为可靠。
- 贝叶斯后验概率 取值 0 到 1,通常以 0.95 为界。读的时候要留神:Suzuki、Glazko 和 Nei 表明这类数值可能偏高。
如果一个节点没有标数字,这张图就没有对它的支持度作任何交代。别在它上面搭结论。
需要的术语,每个一句话
- 单系群(clade) —— 一个祖先加上它的全部后代,现存的和灭绝的都算。
- 单系的(monophyletic) —— 就是一个单系群。不缺,也不多。
- 并系的(paraphyletic) —— 一个祖先加上部分后代。不含鸟类的"爬行动物"是标准案例。
- 拓扑(topology) —— 只有分支模式,剥掉长度。
- 多歧分支(polytomy) —— 一个节点下有三条或更多后代支系而不是两条,通常意味着数据分不出先后。
- 分支支持度(branch support) —— 挂在一条分支上的可重复性分数,比如 bootstrap 值。
六种常见误读
拿它当清单,对照检查你自己对一张图的读法。
- 横着读末端。 被问到蛙和鱼更近还是和人更近时,多数读者选鱼,因为鱼就挨在旁边。错:蛙和人都是四足动物,它们与真骨鱼类的亲缘远近完全相同。末端顺序没有意义,因为每个节点都能自由旋转——Gregory 把一棵树比作婴儿床上的旋转挂饰。
- 把从左到右当成进步。 树上没有任何一支比另一支更高级。伯克利的树,不是梯子一页把这个习惯追到了"存在巨链"的观念,并指出一支画在左边还是右边纯属任意。
- 把现存物种当成彼此的祖先。 一棵常规树的所有末端都是同代的。没有哪一个产生了另一个。
- 数节点来排亲缘远近。 增删类群时节点数就会变。伯克利的实例:两栖类和棘皮动物之间隔三个节点,一旦加入鲨鱼就变成四个——而它们实际的亲缘远近一点没动。
- 把长分支读成"什么都没发生"。 一条又长又没有节点的分支,意思是这一支没有记录到分裂事件,不是这一支停止了演化。反向的错误一样常见:变化并不只发生在节点处。
- 读分支图上的间距。 间距大、间距小、分支长、分支短——在分支图上,这些都不是数据。
可以拿来练手的真实树图
- Nextstrain 的 SARS-CoV-2 分析 有一个 Branch Length 开关,两档:TIME 和 DIVERGENCE。切一下,看同一个拓扑先重绘成时间树、再重绘成支长树。这是最快建立体感的办法。
- Gregory 论文的图 8 把同一个拓扑并排画成分支图、支长树和等距树(ultrametric),推理过程也写明了。
- NCBI 的 Common Tree 根据一份物种名单、用 NCBI 分类学建树。由于分类学本身没有分支长度,出来的东西就是拓扑——一张分支图。
- TimeTree 回答的是另一个问题:给一对物种,返回已发表的分歧时间,属于时间树的地盘。
那么你该画哪一种?
画和你图注里那句主张相匹配的那一种。
- 只主张事件顺序 —— 分支图既诚实又好读。
- 主张某一支变化更多 —— 需要带标度的分支,加一条标尺条。
- 给分裂事件标年代 —— 需要时间坐标轴,以及支撑你论点的那些节点上的支持度数值。
无论选哪种,机制都是同样三样输入:拓扑、可选的分支长度、标签。我们的系统发育树生成器接受 Newick 字符串或纯物种名单,导出 SVG 或 PNG。给它一段不带长度的 Newick,得到的就是一棵真正的分支图:末端齐平、没有标尺条,不暗示任何你的数据支撑不了的东西。如果这棵树最终只是一张汇总图里的一个面板,图形摘要制作工具负责那种排版。
投稿之前还有一件事要定:如果图里有任何部分出自 AI 工具,先查清目标期刊要求你披露什么。我们把现行规则整理在AI 生成图与期刊政策一文里。
常见问题
分支图算系统发育树吗?
它是系统发育树的一种——只展示分支顺序的那一种。很多生物学家把这两个词混用,这正是上面那三步检查值得做的原因:别去信图注里的标签。
分支图能显示时间吗?
不能。分支长度不行,间距不行,末端顺序也不行。一张图既没有坐标轴又没有标尺条,它就没有对时间或变化量作出任何主张。
外群怎么选?
选那个大家公认落在你的内群之外、又能可靠比对的最近类群。选完回头检查它有没有跑到内群里面去——如果跑进去了,说明你的内群不是你以为的那个。
bootstrap 值多少才够?
标准 bootstrap 通常以 80% 以上为界,70% 是更老更弱的那条线。超快 bootstrap 用 95%。永远不要把 UFBoot 的数值和标准 bootstrap 的数值放到同一把尺子上。
两个物种在末端挨着,它们是近亲吗?
不一定。旋转任何一个节点,末端顺序就变了,而树完全没变。把两个末端都往下追到它们汇合的那个节点,再拿这个节点和其他可能性比较。这是唯一的判据。