 Figwise-Team
Die offizielle PRISMA-Website stellt die Vorlage bereit. Sie erklärt jedoch nicht, was in jede Box gehört oder warum sich Ihre Zahlen nicht addieren lassen. Dieser Leitfaden tut beides.
Hier die Kurzfassung. Jede Box im PRISMA-2020-Flussdiagramm enthält eine Zahl aus Ihren Screening-Datensätzen. In jeder Phase muss die eingetragene Zahl der Summe aus der weitergeführten und der entfernten Zahl entsprechen. Und seit 2020 zählen die letzten Boxen Studien und Berichte getrennt – die eine Änderung, an der die meisten Autorinnen und Autoren scheitern.
Im Folgenden finden Sie:
- Was jede Box bedeutet und woher ihre Zahl stammt
- Die acht Rechenregeln, die als Checkliste zur Selbstkontrolle erfüllt sein müssen
- Ein vollständig durchgerechnetes Beispiel sowie ein veröffentlichtes Diagramm, in dem es einen Fehler gibt
- Die offizielle Vorlage, das R-Paket und einen kostenlosen PRISMA flow diagram generator, der das Diagramm aus Ihren Zahlen erstellt
Zuerst die richtige Vorlage auswählen
Es gibt vier offizielle Vorlagen, nicht nur eine. Neue Reviews und aktualisierte Reviews haben jeweils ihre eigene Version. Jede gibt es mit oder ohne zusätzliche Spalte für Quellen außerhalb von Datenbanken und Registern.
| Vorlage | Verwendung |
|---|---|
| Neue Review, nur Datenbanken und Register | Die meisten systematischen Reviews. Sie haben Datenbanken wie PubMed oder Embase und möglicherweise Studienregister durchsucht. |
| Neue Review mit weiteren Quellen | Sie haben Datensätze zusätzlich über Websites, Organisationen oder eine Zitationssuche gefunden. Eine zweite Spalte wird ergänzt. |
| Aktualisiertes Review, nur Datenbanken und Register | Sie aktualisieren ein veröffentlichtes Review und müssen alte und neue Studien zeigen. |
| Aktualisiertes Review mit weiteren Quellen | Beides zusammen. |
Alle vier sind kostenlose Word-Dateien auf der offiziellen PRISMA-Seite zum PRISMA-Flussdiagramm und unter CC BY 4.0 lizenziert. Der restliche Leitfaden geht die Standardversion durch: neue Review, nur Datenbanken und Register. Die Spalte „other methods“ folgt derselben Logik mit einer Besonderheit, die weiter unten behandelt wird.
Die offizielle Seite zum Herunterladen der Vorlage auf prisma-statement.org, aufgenommen am 23. August 2026.
Box für Box: Welche Zahl kommt wohin
Drei Begriffe bestimmen das gesamte Diagramm, und die PRISMA-2020-Erklärung definiert sie genau:
- Ein Datensatz ist „der Titel oder das Abstract (oder beides) eines Berichts, der in einer Datenbank oder auf einer Website indexiert ist.“ Zwei Datensätze, die auf denselben Bericht verweisen, sind Duplikate; Datensätze, die nur auf ähnliche Berichte verweisen, sind keine Duplikate.
- Ein Bericht ist ein einzelnes Dokument: ein Artikel, ein Preprint oder eine Dissertation.
- Eine Studie ist eine Untersuchung, die in mehreren Berichten beschrieben sein kann.
Im oberen Teil des Diagramms werden Datensätze gezählt. In der Mitte werden Berichte gezählt. Im unteren Teil werden Studien und Berichte gezählt.
Identifizierte Datensätze
Tragen Sie die Rohzahl aus jedem Such-Export ein, bevor Duplikate entfernt werden. Datenbanken (PubMed, Embase, Scopus ...) und Register (ClinicalTrials.gov, ICTRP ...) erhalten separate Zeilen. Ihre Quelle ist die Exportdatei oder die am Suchdatum protokollierte Zahl unter „results“.
Die Fußnote der Vorlage bittet um mehr Details, wenn Sie diese angeben können:
„Geben Sie, sofern möglich, die Zahl der aus jeder durchsuchten Datenbank bzw. jedem Register identifizierten Datensätze an (statt der Gesamtzahl über alle Datenbanken/Register hinweg).“
„Datenbanken (n = 644)“ ist also akzeptabel, aber „PubMed (n = 312), Embase (n = 245) ...“ ist besser.
Vor dem Screening entfernte Datensätze
Diese Box hat drei Unterzeilen mit jeweils einer eigenen Bedeutung:
- Entfernte doppelte Datensätze — die Zahl, die Ihr Literaturverwaltungs- oder Screening-Tool (EndNote, Zotero, Covidence, Rayyan) nach der Deduplizierung meldet.
- Von Automatisierungstools als nicht geeignet markierte Datensätze — Datensätze, die ein Klassifikator oder Filter ohne menschliche Prüfung entfernt hat. Bei den meisten Reviews ist die Zahl null; schreiben Sie n = 0, statt die Zeile zu löschen.
- Aus anderen Gründen entfernte Datensätze — alles andere, was vor dem Screening entfernt wurde, etwa Datensätze außerhalb Ihrer zeitlichen Grenzen, die durchgerutscht sind.
Gescreente Datensätze, ausgeschlossene Datensätze
„Gescreente Datensätze“ sind die Datensätze, die in das Screening von Titel und Abstract gelangt sind. Ihre Zahl muss den identifizierten Datensätzen minus allem entsprechen, was vor dem Screening entfernt wurde. „Ausgeschlossene Datensätze“ sind die Datensätze, die die Screenenden in dieser Phase zurückgewiesen haben. Hier sind keine Begründungen erforderlich – eine Ebene tiefer werden sie verpflichtend.
Eine Fußnote gilt, wenn Software geholfen hat:
„Wenn Automatisierungstools verwendet wurden, geben Sie an, wie viele Datensätze von einem Menschen und wie viele durch Automatisierungstools ausgeschlossen wurden.“
Zur Volltextbeschaffung gesuchte Berichte, nicht beschaffte Berichte
Hier wechselt die Einheit von Datensätzen zu Berichten: Jetzt versuchen Sie, die Volltexte zu beschaffen. „Zur Volltextbeschaffung gesuchte Berichte“ entspricht den gescreenten Datensätzen minus den ausgeschlossenen Datensätzen. „Nicht beschaffte Berichte“ zählt die Volltexte, die Sie nicht erhalten konnten – Paywalls ohne Bibliothekszugang, Konferenzabstracts ohne Artikel oder Autorinnen und Autoren, die nie geantwortet haben.
Auf Eignung geprüfte Berichte, ausgeschlossene Berichte
Screening des Volltexts. „Auf Eignung geprüfte Berichte“ entspricht den zur Beschaffung gesuchten Berichten minus den nicht beschafften Berichten. Die Ausschlussbox ist die einzige Stelle, an der Begründungen erforderlich sind, und jeder Grund braucht eine eigene Zahl:
- falsche Population (n = ...)
- falsche Intervention (n = ...)
- falsches Studiendesign (n = ...)
Die Begründungszahlen müssen sich zur Gesamtzahl der ausgeschlossenen Berichte summieren.
In die Review eingeschlossene Studien, Berichte über eingeschlossene Studien
Die letzte Box enthält zwei Zahlen, und dies ist die zentrale Änderung gegenüber PRISMA 2009. Das alte Diagramm endete mit einer einzigen Zahl für „Studien“. PRISMA 2020 verlangt eine Trennung, weil ein einzelner Trial oft mehrere Publikationen hervorbringt. Wenn 24 Studien eingeschlossen wurden und 5 davon einen zweiten verknüpften Bericht hatten, schreiben Sie: In die Review eingeschlossene Studien (n = 24); Berichte über eingeschlossene Studien (n = 29).
Die Spalte „other methods“, falls Sie sie brauchen
Die Vorlagenversion 2 ergänzt rechts eine zweite Spalte für Datensätze, die über Websites, Organisationen oder eine Zitationssuche gefunden wurden. Sie hat eigene Boxen für „gesucht“, „nicht beschafft“ und „geprüft“ sowie eine vollständige Reports excluded-Box mit eigenen Begründungszeilen. Was ihr fehlt, ist eine Screening-Phase: Auf dieser Seite gibt es keine Records screened- oder Records excluded-Box. Die beiden Spalten werden erst in der letzten Box für eingeschlossene Studien zusammengeführt.
Die Zahlen zum Aufgehen bringen: die Bilanzregeln
Das Diagramm besteht aus einer Reihe von Bilanzprüfungen. Führen Sie alle acht durch, bevor Sie etwas exportieren:
- Datenbanken + Register = die Identifikationssumme, von der Sie subtrahieren
- Duplikate + durch Automatisierung entfernte Datensätze + sonstige Entfernungen = alles, was vor dem Screening entfernt wurde
- Identifizierte Datensätze − vor dem Screening entfernte Datensätze = gescreente Datensätze
- Gescreente Datensätze − ausgeschlossene Datensätze = zur Volltextbeschaffung gesuchte Berichte
- Zur Beschaffung gesuchte Berichte − nicht beschaffte Berichte = auf Eignung geprüfte Berichte
- Auf Eignung geprüfte Berichte − ausgeschlossene Berichte = Berichte über eingeschlossene Studien
- Summe der einzeln aufgeführten Ausschlussbegründungen = Gesamtzahl der ausgeschlossenen Berichte
- Berichte über eingeschlossene Studien ≥ in die Review eingeschlossene Studien
Prüfungen 1 und 2 gibt es, weil die offizielle Vorlage keine Boxen für Gesamtsummen hat: Oben stehen separate Zeilen für Datenbanken und Register, und die Entfernungsbox enthält drei Unterzeilen. Sie addieren die Werte selbst, und genau hier treten die ersten Fehler auf.
Wenn eine Prüfung fehlschlägt, liegt die Ursache meistens in einem von drei Bereichen:
- Eine Abweichung bei der Duplikatzählung. EndNote und Covidence zählen Duplikate unterschiedlich. Übernehmen Sie daher jede Zahl aus dem Protokoll eines einzigen Tools und mischen Sie keine Werte.
- Eine Verwechslung von Datensätzen und Berichten. Ein auf Abstract-Ebene ausgeschlossener Datensatz und ein auf Volltextebene ausgeschlossener Bericht sind unterschiedliche Ereignisse. Wenn Sie einen Wert zwischen den Ebenen verschieben, brechen gleich zwei Prüfungen.
- Begleitpublikationen. Wenn Sie bei der Datenextraktion drei Publikationen zu einer Studie zusammengeführt haben, sinkt die Studienzahl, aber die Zahl der Berichte darf nicht sinken.
Ein durchgerechnetes Beispiel mit eingesetzten Zahlen
Das folgende Diagramm ist ein durchgerechnetes Beispiel, kein echtes Review – die Zahlen stammen von uns und wurden so gewählt, dass jede Regel erfüllt ist. Wir haben es mit unserem eigenen PRISMA flow diagram generator erstellt. Sie geben 13 Zahlen ein, der Generator erstellt das Standarddiagramm, und Sie exportieren SVG oder PNG. Er ist kostenlos und läuft im Browser ohne Login.
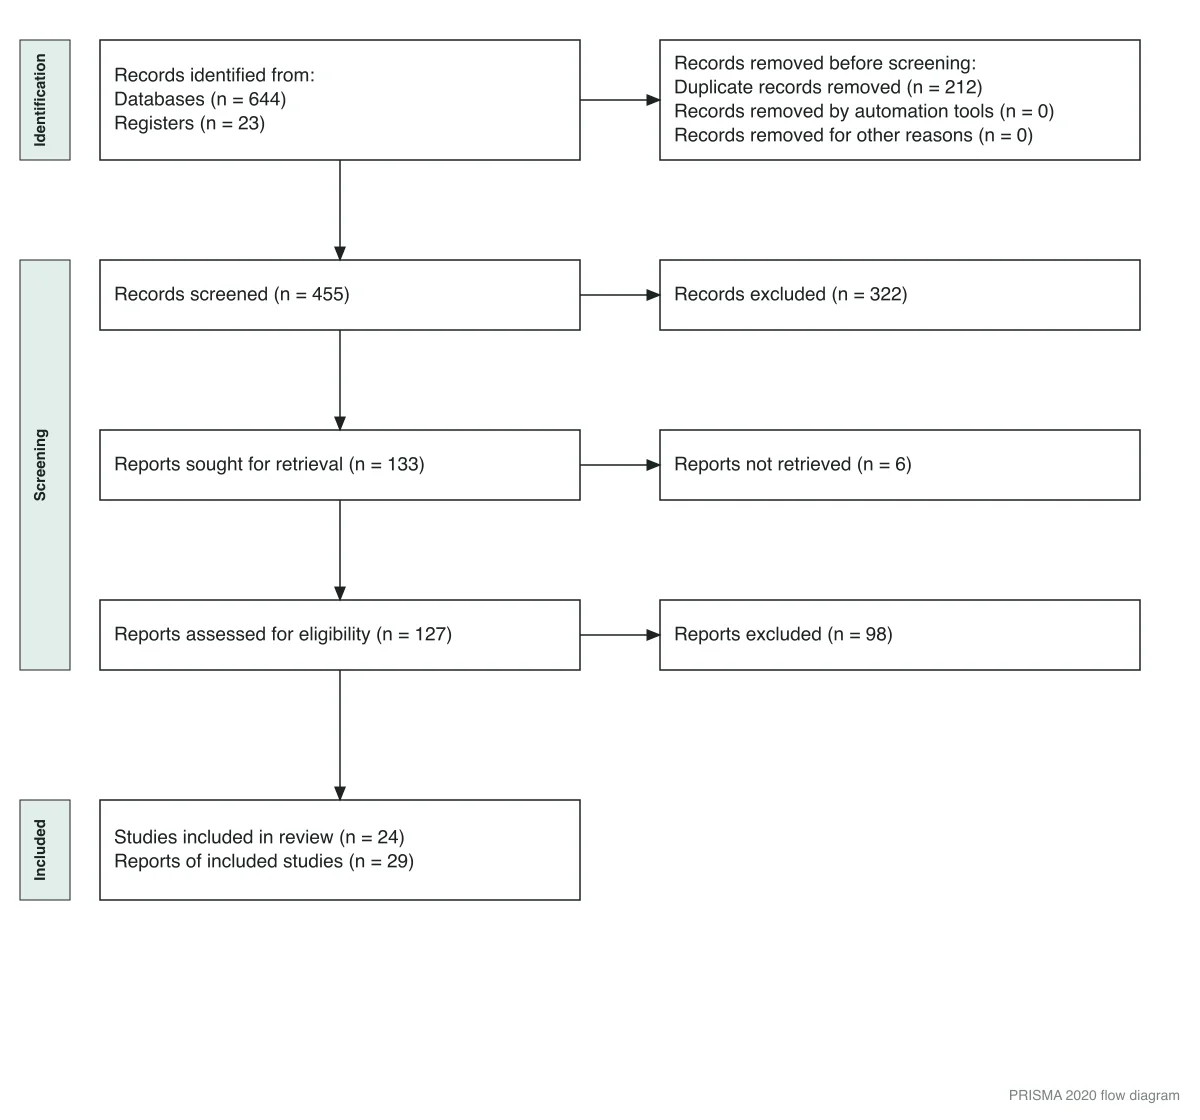
Ein mit dem FigWise PRISMA generator erstelltes Beispiel. Jede Ebene ist ausgeglichen: 667 − 212 = 455; 455 − 322 = 133; 133 − 6 = 127; 127 − 98 = 29 Berichte aus 24 eingeschlossenen Studien.
Gehen Sie es einmal durch: 644 Datenbankdatensätze plus 23 Registerdatensätze ergeben 667. Entfernen Sie 212 Duplikate, sodass 455 zum Screening verbleiben. Die Screenenden schließen 322 aus, also werden 133 Volltexte gesucht; 6 können nicht beschafft werden, sodass 127 geprüft werden. Die Volltextprüfung schließt 98 aus, sodass 29 Berichte verbleiben, die 24 Studien beschreiben.
Drei Hinweise zur korrekten Einordnung des Tools:
- Es deckt nur die Standardvorlage für neue Reviews ab. Es gibt keine Spalte „other methods“ und keine Version für aktualisierte Reviews; verwenden Sie dafür die offizielle Word-Datei.
- Die Formulierung entspricht weitgehend der offiziellen Vorlage, ist aber nicht identisch – die Automatisierungszeile lautet „Records removed by automation tools“, während die Vorlage „Records marked as ineligible by automation tools“ sagt – und weder die Spaltenüberschrift noch die beiden oben zitierten Fußnoten mit Sternchen werden ausgegeben. Wenn Ihr Journal das Diagramm mit der Vorlage abgleicht, bearbeiten Sie den Text im exportierten SVG.
- Die Ausschlussbox enthält nur eine Gesamtsumme. Das exportierte SVG enthält echten, bearbeitbaren Text, aber die Box hat eine feste Höhe und keinen Zeilenumbruch – drei oder vier Begründungszeilen laufen über den Rand, wenn Sie nicht auch die Box vergrößern. Für eine aufgeschlüsselte Ausschlussbox macht die offizielle Word-Vorlage weniger Arbeit.
Auch veröffentlichte Diagramme enthalten solche Fehler
Bilanzprüfungen sind keine akademische Formsache. Eine systematische Review aus dem Jahr 2026 in Frontiers in Dental Medicine (DOI: 10.3389/fdmed.2026.1720637) zeigt, wie leicht ein peer-reviewtes Diagramm vom eigenen Text abweichen kann.
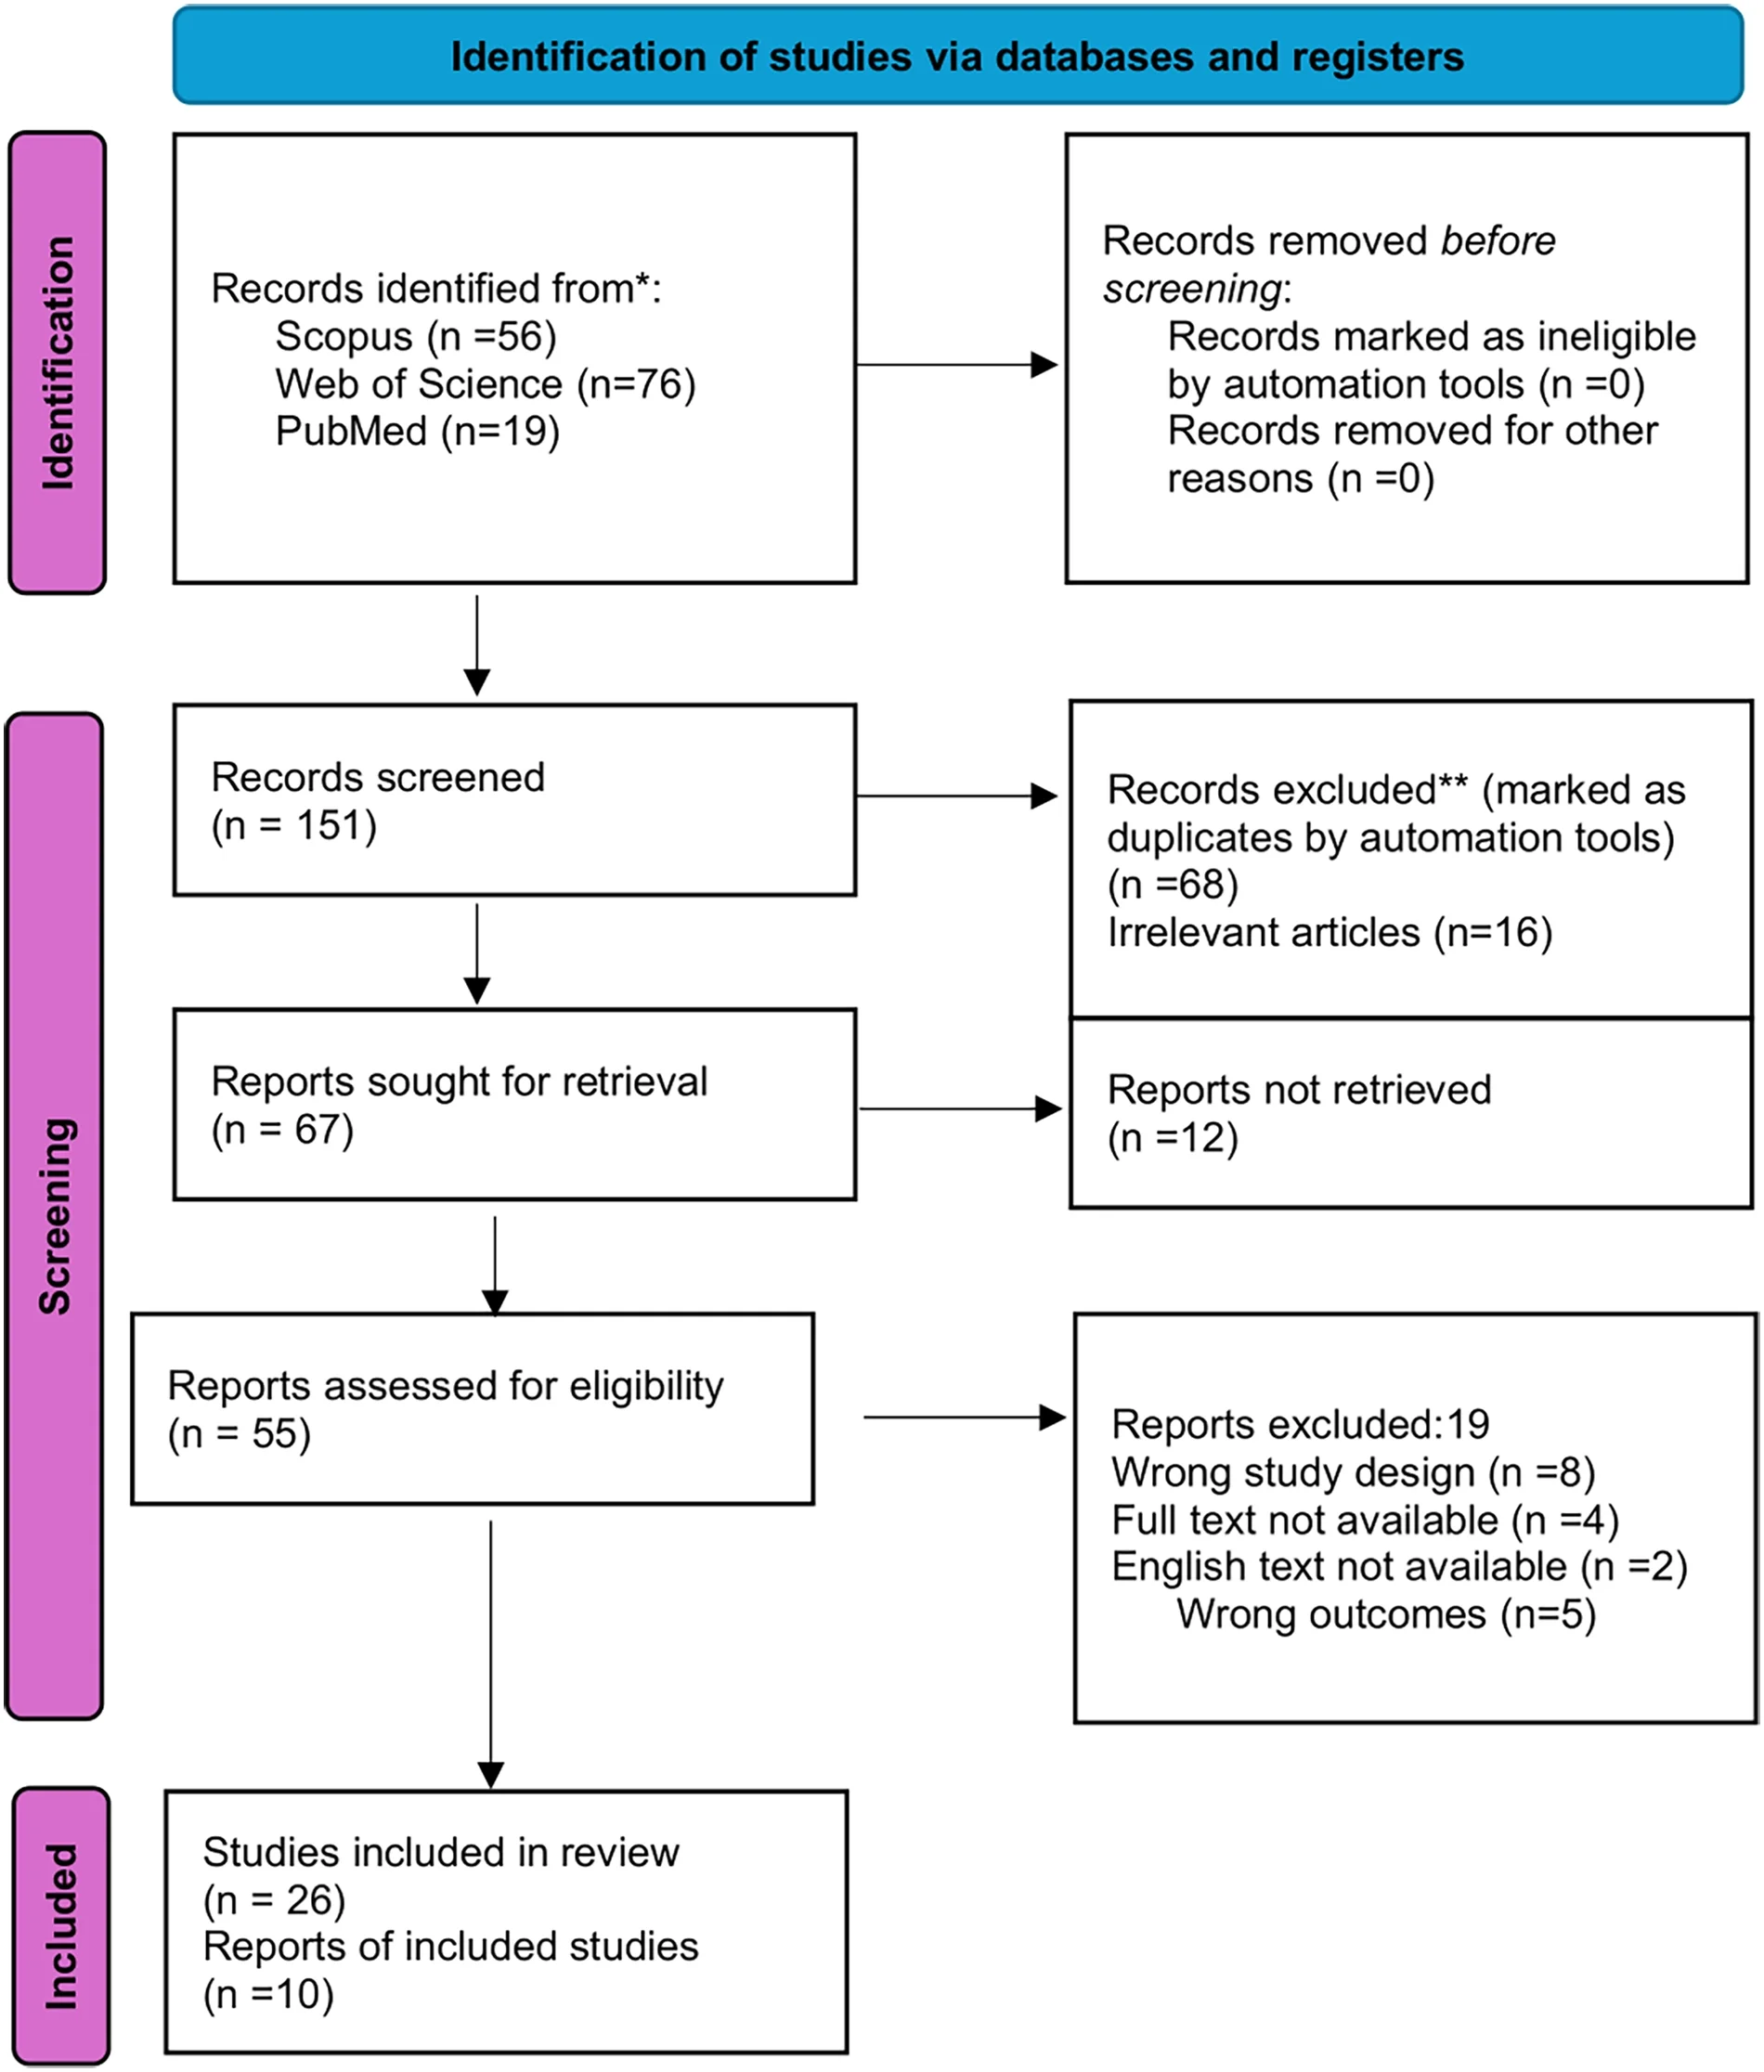
Diagramm 1 von Harikrishna et al., Frontiers in Dental Medicine, 2026, unverändert unter CC BY 4.0 reproduziert. Vergleichen Sie die Zahlen mit dem Artikeltext und den obigen Bilanzprüfungen.
Drei Abweichungen sind sichtbar:
- Das Diagramm bezeichnet die Rohsumme von 151 als „Records screened“. Anschließend verschiebt es die Entfernung von Duplikaten nach unten in die Ausschlussbox der Screening-Phase, in der die Vorlage themenbezogene Ausschlüsse vorsieht.
- Die Entfernungszahlen des Diagramms lauten 68 Duplikate und 16 irrelevante Datensätze; im Text heißt es: „65 duplicates were removed by automation tools and 19 records were excluded as clearly irrelevant.“ Beide ergeben zusammen 84, und 151 − 84 = 67 stimmt in beiden Versionen mit der nächsten Box überein – die Summen stimmen also, nur die Aufteilung nicht.
- Die Box
Records removed before screeningführt Automatisierung (n = 0) und andere Gründe (n = 0) auf; die ZeileDuplicate records removedwurde gelöscht, statt mit einer Zahl versehen zu werden. Das ist der Checklistenpunkt drei Zeilen weiter unten – hier in freier Wildbahn. - Die letzte Box lautet 26 Studien aus 10 Berichten, während der Text meldet, dass „36 studies fulfilled the eligibility criteria.“ Berichte über eingeschlossene Studien können nie weniger sein als Studien. Der Text erklärt, woher 26 und 10 stammen: „10 CFD studies provided extractable, needle-specific wall shear stress data… The remaining 26 included studies contributed contextual information.“ Die beiden Boxen enthalten also eine Aufteilung der 36 nach Datentyp, nicht eine Anzahl von Studien und Berichten.
Nichts davon ändert die Ergebnisse der Review. Es zeigt, dass das Diagramm überprüfbar ist – und dass Reviewer es tatsächlich prüfen.
Häufige Fehler: die abschließende Checkliste
Prüfen Sie vor der Einreichung jede Zeile:
- Obere Boxen enthalten rohe, vor der Deduplizierung exportierte Zählwerte
- Register stehen in einer eigenen Zeile, nicht zusammen mit Datenbanken
- Jede leere Unterzeile lautet n = 0, statt gelöscht zu werden
- Duplikate stehen unter „vor dem Screening entfernt“, nicht bei den Screening-Ausschlüssen
- Ausschlussbegründungen für Volltexte sind einzeln aufgeführt und ergeben zusammen die Gesamtzahl
- Berichte über eingeschlossene Studien ≥ in die Review eingeschlossene Studien
- Alle acht Bilanzprüfungen sind erfüllt
- Diagrammzahlen stimmen mit den Zahlen in Abstract und Ergebnisteil überein
Tools: Vorlage, R-Paket, Shiny-App und diese Website
Vier Optionen decken die meisten Situationen ab:
- Offizielle Word-Vorlagen — die Referenzformulierung, ideal wenn Ihr Journal eine bearbeitbare Datei verlangt oder Sie die Layouts für weitere Methoden oder aktualisierte Reviews brauchen.
- PRISMA2020-R-Paket — am besten für reproduzierbare Pipelines; das Diagramm wird aus einer Datendatei neu erstellt, wenn sich die Zahlen ändern. Die Quelle liegt auf GitHub, und die Methode ist in einer Open-Access-Publikation von Haddaway und Kollegen beschrieben.
- Die Shiny-App — dieselbe Engine mit Formularoberfläche, ohne R. Sie läuft im kostenlosen Tarif von shinyapps.io, für den es keine Verfügbarkeitsgarantie gibt; das lokale Paket ist die Ausweichlösung.
- FigWise PRISMA flow diagram generator — am schnellsten für das Standarddiagramm: 13 Zahlen eingeben, die Live-Vorschau verfolgen, SVG oder PNG exportieren. Für die Berichterstattung randomisierter Studien gilt derselbe Ansatz in unserem CONSORT flow diagram generator.
Wenn irgendein anderes Diagramm in Ihrem Manuskript aus einem KI-Tool stammt, prüfen Sie was Verlage tatsächlich erlauben – die Regeln unterscheiden sich stark, und Flussdiagramme werden nicht wie Datenbilder behandelt.
FAQ
Brauche ich das Diagramm auch, wenn meine Suche nur sehr wenige Studien ergeben hat?
Ja, in der Praxis. Punkt 16a fordert, „[b]eschreiben Sie die Ergebnisse der Suche und des Auswahlprozesses – von der Zahl der in der Suche identifizierten Datensätze bis zur Zahl der in die Review eingeschlossenen Studien, idealerweise mithilfe eines Flussdiagramms“. Beachten Sie idealerweise – der Punkt kann auch im Fließtext erfüllt werden. Journals, die PRISMA unterstützen, erwarten das Diagramm jedoch unabhängig davon, ob Sie 90 Datensätze oder 9,000 gescreent haben.
Was zählt als Register, und was ist, wenn ich keines durchsucht habe?
Register sind prospektive Studienregister wie ClinicalTrials.gov oder das WHO ICTRP. Wenn Sie keines durchsucht haben, schreiben Sie Registers (n = 0) oder entfernen Sie die Zeile – erwähnen Sie es aber in Ihrer Methodik, da viele Journals bei Reviews zu Studien eine Registersuche erwarten.
Kann ich stattdessen das PRISMA-2009-Diagramm verwenden?
Nein. Die PRISMA-2020-Erklärung sagt, sie „ersetzt die PRISMA-2009-Erklärung, die nicht länger verwendet werden sollte“. Das alte Diagramm endet außerdem mit einer einzigen Zahl für „studies included“ und kann daher die Aufteilung zwischen Studien und Berichten nicht darstellen.
Woher kommen die Ausschlussbegründungen?
Aus Ihrem Volltext-Screeningprotokoll. Tools wie Covidence und Rayyan exportieren für jeden Bericht eine Begründung. Fassen Sie sie zu einer kurzen Liste zusammen – falsche Population, falsche Intervention, falsches Design, falscher Endpunkt – und achten Sie darauf, dass die Summen weiterhin der Gesamtzahl entsprechen.