 Figwise 团队
系统综述要找到、评判并综合所有回答同一个既定问题的研究。方法在开始前就定好,并完整报告出来。最后这一点才是"系统"的含义:读者能重跑你的流程,落到同一批研究上。
它也很慢。一项针对 PROSPERO 注册库中 195 篇已完成综述的研究发现,从注册到论文发表平均 67.3 周,平均 5 位作者(Borah 等,2017;样本取自 2014 年)。所以这篇不只列步骤。每一步都指明你必须产出什么——以及哪些错误会逼团队重来。
以下是 10 步。每一步结束时都有可以打勾的东西。
第 0 步:先确认系统综述是不是对的工具
三种情况下,跳过系统综述,或者换一种综述类型。
- 问题太宽。 "什么疗法对抑郁有效?"会命中几万条记录。Cochrane 手册提醒不要提出会拉进超出团队处理能力的记录量的问题。把人群、干预,或者两者一起收窄。
- 已有近期综述回答过了。 在 PROSPERO 搜已注册和在做的综述,在 PubMed 搜已发表的。如果最近几年有一篇扎实的综述覆盖了你的问题,再做一篇重复的意义不大。
- 证据太少或太杂,合并不了。 如果你预计只有少数几项设计差异极大的研究,范围综述(scoping review)更合适——它是把已有的东西画成地图,而不是合并结果。注意 PROSPERO 目前不接受范围综述,那类要注册到别处(例如 Open Science Framework)。
三道检查都过了,就往下做。
第 1 步:用 PICO 把问题框住,并组队
用 PICO 把话题变成一个清楚的问题。这几个字母代表人群(Population)、干预(Intervention)、对照(Comparator)和结局(Outcome)。
给一个完整的例子。话题:"运动与抑郁"。PICO 版本:
- P——诊断为重度抑郁障碍的成年人(18 岁以上)
- I——有督导的有氧运动方案
- C——常规治疗或等待名单对照
- O——用经过验证的量表测得的抑郁症状评分变化
问题于是读作:
在重度抑郁障碍成年人中,与常规治疗相比,有督导的有氧运动能否降低抑郁症状评分?
后面每一个选择都从这四部分流出来——检索词、纳入规则、提取字段。定性问题用 SPIDER 框架起同样的作用。
现在就组队,不要拖到后面。 你至少需要两位评价者。筛选和偏倚评估必须由两个人分开各做一遍。检索环节加一位图书馆员,如果可能要合并结果,再加一位统计学家。
- **你要产出:**一句话的 PICO 问题,以及一份写明分工的团队名单。
- **工具:**不需要,一份共享文档就够。
- **常见返工原因:**结局定得含糊("有效性"),后面裂成好几个谁也没商量过的结局。现在就把具体测量指标钉死。
第 2 步:写协议并在 PROSPERO 注册
协议在你看到任何结果之前把方法固定下来。它覆盖问题、纳入排除规则、计划检索的数据库、筛选流程、提取字段、偏倚工具和综合方案。这是你对抗偏倚的防线:规则带时间戳躺在公开注册库里,就没人能指责你为了迁就结果而改规则。
在 PROSPERO 注册,它是面向人类健康类结局综述的全球注册库。时点规则很严:**已经开始数据提取的综述,注册库不接受。**协议起草完、正式筛选开始前注册——实际操作上,就在检索之前或与检索同时。
现在这版 PROSPERO 于 2025 年 2 月上线。它的说明页写明了所有团队成员确认之后会发生什么:
"a registration number is assigned and the registration record is published immediately on the PROSPERO site. There is no delay to publication."(分配注册号,注册记录立即在 PROSPERO 站点上发布,发布没有延迟。)
代价写在同一页上:PROSPERO "does not check record content (beyond built-in automatic checks) and does not provide peer review."(除内置自动检查外,PROSPERO 不审查记录内容,也不提供同行评议。)记录的质量归你自己负责。
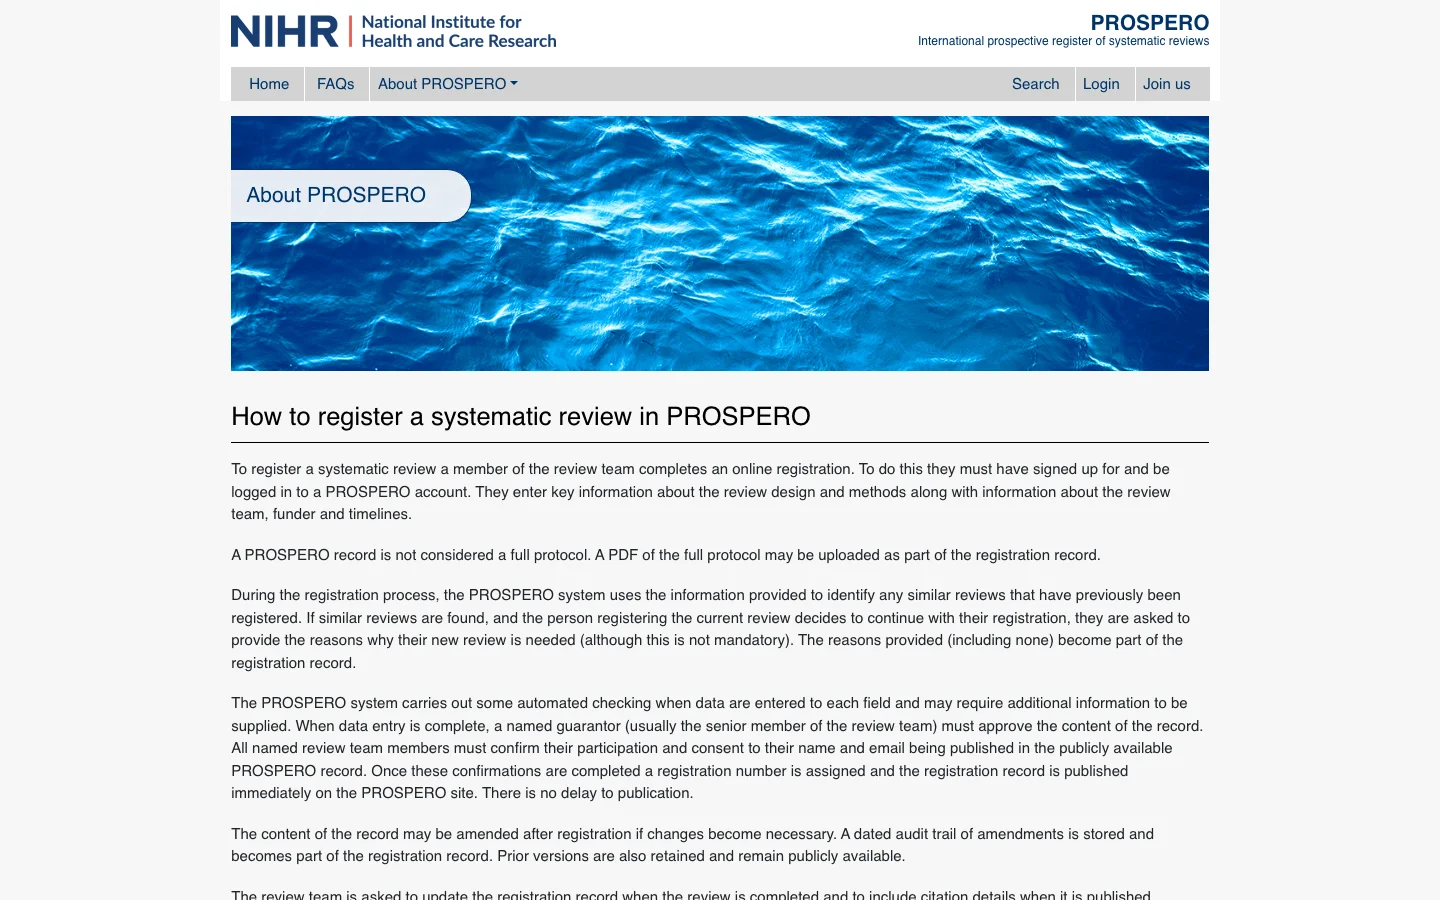
PROSPERO 的"How to register"页面,描述当前的即时发布流程。来源:crd.york.ac.uk,2026 年 8 月 23 日截取。
- **你要产出:**一份已注册的协议,带 PROSPERO 编号。
- **工具:**PROSPERO 免费。完整协议 PDF 可以附在记录里。
- **常见返工原因:**筛选开始之后才注册。期刊会拿注册日期和你 PRISMA 流程图上的日期对照,注册太晚等于把这件事的意义抽掉了。
第 3 步:搭检索策略
目标是查全率优先于查准率:把每一项相关研究都捞进来,接受捞上来的大部分最终会被扔掉。在 Borah 那项研究里,纳入研究平均只占检出记录的 2.94%。一个感觉宽得浪费的检索,通常是对的。
至少检索三个数据库。做试验类综述时,Cochrane 把 CENTRAL、MEDLINE 和 Embase 定为最低集合:
在每个库里,都要把受控词(PubMed 里的 MeSH)和自由词混着用,因为标引有滞后、各库还不一样。
下面是针对第 1 步那个例子、可以直接跑的 PubMed 检索式:
("Exercise"[Mesh] OR exercis*[tiab] OR "physical activity"[tiab] OR "aerobic training"[tiab])
AND
("Depressive Disorder"[Mesh] OR "Depression"[Mesh] OR depress*[tiab])
AND
(randomized controlled trial[pt] OR randomized[tiab] OR randomised[tiab])
每一块都把 MeSH 词和 [tiab] 自由词变体配成对。exercis* 里的星号能抓住这个词的所有词尾。[pt] 过滤限定到试验类文献,而自由词部分能抓到尚未标引的试验。
然后覆盖灰色文献:
- 试验注册库——ClinicalTrials.gov 和 WHO ICTRP
- 会议摘要
- 已纳入研究的参考文献列表
漏掉未发表的试验,你的综述就会偏向阳性结果。
**跑之前请图书馆员过一遍策略。**检索语法各库不同,漏掉一个同义词就可能藏掉一簇研究。把一个检索式从一个库搬到另一个库时也容易出错,而且很难发现。
这一步花一小时找专家看,能省下几个月。
- **你要产出:**每个数据库的完整检索式,带运行日期和命中数——PRISMA 要求你逐字报告这些。
- **工具:**PubMed 免费;Embase、CINAHL、PsycINFO 通常需要机构订阅。
- **常见返工原因:**筛选做完之后才发现漏了一个关键词,于是被迫重新检索、再筛一轮。
第 4 步:导出并去重
把所有命中导入同一个文献管理器并去重。同一项研究会在多个数据库里出现,数两遍的话,你的筛选数字和结果都会错。
**动手之前先记两个数:**每个数据库的记录总数,以及移除的重复数。这两个数后面都要进 PRISMA 流程图,而且事后无法重建。
- **你要产出:**一个去重后的文献库,加上那些计数。
- 工具:Zotero(免费)或 EndNote(收费);Rayyan、Covidence 这类筛选工具在导入时也会去重。
- **常见返工原因:**对每个数据库的导出各自去重,结果搞不清合并后的总数。
第 5 步:两级筛选,两位评价者
筛选要做两轮。第一轮只看标题和摘要,依你协议里的规则判断——拿不准就先留着。第二轮看所有存活条目的全文,每一项被剔除的研究都要记下理由。
两轮都需要两位评价者各自独立进行,冲突通过讨论或第三位评价者裁定。这不是客套:一个人单独筛会漏研究。PRISMA 第 8 条要求你说明有几个人筛了每条记录、是否独立进行。Cochrane 把双人筛选列为应达到的标准。
有两条规则能保护你不落入隐性偏倚:
不要因为一项研究没报告你的结局就排除它。 如果一项试验测了抑郁评分却从未发表,把它剔掉等于奖励选择性报告。留着,然后去追数据。
按类别记录全文排除理由("人群不符""对照不符""非随机")。PRISMA 要求这些理由,而事后靠回忆重建会非常痛苦。
**你要产出:**最终纳入研究清单,以及流程图需要的计数和排除理由。
工具:Rayyan 有免费档,支持盲法双人筛选。Covidence 收费(截至 2026 年 8 月,单篇综述 339 美元/年;很多高校图书馆有机构授权),覆盖从筛选到提取。
**常见返工原因:**筛到一半才发现标准模糊("成年人"——16 岁算不算?)。先在 50–100 条记录上试筛,把措辞改定再进入全量。
第 6 步:用试跑过的表格提取数据
按你的 PICO 各部分搭一张结构化表格:研究设计、场景、样本量、参与者、每组做了什么、结局数据(均值、标准差、事件数),以及资助来源。然后先在三到五项研究上试跑,再做其余的。试跑几乎总能暴露漏掉的字段。
提取要么双人各做一遍,要么让第二位评价者抽查一部分。另外要把同一项研究的多份报告合并。一项试验发表成协议论文、结果论文和随访论文,那是一项研究,不是三项。数三遍就等于给了它三倍权重。
- **你要产出:**一张覆盖所有纳入研究的完整提取表。
- **工具:**电子表格就够,免费;Covidence 内置提取表单。
- **常见返工原因:**没试跑的表格漏了字段(亚组数据、不良事件),于是每份 PDF 都得重看一遍。
第 7 步:评估偏倚风险——工具取决于研究设计
偏倚风险问的是:每项研究的设计有没有可能让结果偏掉。分组真的随机吗?评分者盲法了吗?各组的脱落情况有差别吗?
一个来自有缺陷试验的精确数字,仍然是个有缺陷的数字。
工具不是自由选择——它由你纳入的研究设计决定:
| 研究设计 | 工具 | 在哪 |
|---|---|---|
| 随机对照试验 | RoB 2 | Cochrane RoB 2 页面 / riskofbias.info |
| 非随机的干预研究,含队列与病例对照设计 | ROBINS-I | Cochrane ROBINS-I 页面 |
| 非干预类问题的观察性研究(病因、预后) | Newcastle-Ottawa 量表 | 渥太华方法学中心 |
三个都免费。如果你的问题是关于干预效果的,即使研究设计是队列或病例对照,也用 ROBINS-I——这是 Cochrane 手册的要求,也是审稿人的预期。另外注意 Newcastle-Ottawa 给的是星级评分,所以它产出不了这一步要求的按领域判断。
双人评分,按每个领域分别判断而不是给一个总分,而且要计划把评分用起来——比如检查一下剔除高风险研究后结论是否还成立。一张从不触及结果的偏倚表只是装饰。
- **你要产出:**一张按研究、按领域的偏倚表,每个判断都写理由。
- **工具:**上面那些官方模板;RevMan 和 Covidence 内嵌了 RoB 2。
- **常见返工原因:**用了与研究设计不匹配的清单——拿 NOS 评试验、拿 RoB 2 评队列研究。审稿人一眼就会指出来。
第 8 步:综合——只有研究允许时才做 meta 分析
每篇系统综述都需要一次结构化的综合。但不是每篇都能做 meta 分析。
只有研究之间足够相似时才合并:
- 核心问题相同
- 人群与治疗相近
- 结局能换算到同一个尺度上
如果你的研究在"比较了什么"或"怎么测量的"这些核心处就不同,那么合并出的均值是一个精确但无意义的数字。
合并不成立时,改写结构化的叙述性综合。按治疗类型或人群分组,报告每组效应的方向和大小,并明确说明你为什么不合并。
"我们没有合并,因为这些研究在临床上差异太大"是一个合理、可发表的结论。硬做的 meta 分析不是。
如果确实要合并:
选定效应量(风险比、均值差)
量化研究间的分歧程度(I²)
亚组分析和敏感性分析要在协议里事先定好
试验数量够的话,检查小研究效应
**你要产出:**森林图和合并估计值,或者一份写明理由的结构化叙述性综合。
**工具:**R 的
metafor或meta包(免费),或 RevMan(需授权,Cochrane 综述作者免费)。合并之前就让统计学家介入,不是之后。**常见返工原因:**协议里承诺了 meta 分析,然后为了兑现承诺把不相似的研究硬凑一起。协议里可以把"是否合并"写成有条件的——就该那么写。
第 9 步:按 PRISMA 2020 报告
健康类期刊预期 PRISMA 2020 声明。它有两部分:一份 27 条清单,覆盖从检索式到资助的一切;以及一张流程图,追踪记录从数据库命中到纳入研究的流向。
流程图正是第 3–5 步记下的那些数字归位的地方:
- 每个数据库的记录数
- 移除的重复数
- 进入筛选与被剔除的记录数
- 评估的全文数,以及每一份被剔除的理由
- 纳入的研究数
官方模板在 PRISMA 流程图页面。我们免费的 PRISMA 流程图生成器能替你画标准的"数据库与注册库"版本:输入计数,输出符合官方 2020 版式的图。
准备图件时,顺便看一下目标期刊对 AI 生成图像的规定。这些规定各家出版社差别很大,而流程图不按数据图那样对待。我们在六家出版社对 AI 图件的实际政策里逐条比过。
清单要边写边填,不要写完再补。如果前面几步做得规矩,多数条目都只是一句实话。
- **你要产出:**填完的 27 条清单(随稿件提交)和流程图。
- **工具:**PRISMA 清单和模板都免费。
- **常见返工原因:**流程图缺计数,因为第 3–5 步没人记。除了把账重做一遍,没有别的办法。
第 10 步:成文、更新注册、投稿
按 PRISMA 的标题组织稿件:
- 背景
- 方法,与协议对应
- 结果——流程、研究特征、偏倚风险、综合
- 讨论与局限
凡是综述偏离了已注册协议的地方,都要说出来并解释原因。审稿人会把两份文件对照着看。
**先选期刊,再打磨。**确认它发表你这类综述,并读它的规则——很多期刊在投稿时就要求 PRISMA 清单和注册编号。然后把它要求的附加材料提前备好。
如果期刊要图摘,先确认你能用哪种工具——有几家出版社明令禁止通用 AI 生图工具做这一件事,我们把它们的实际规定整理过。
最后把 PROSPERO 这个环闭上:
- 把记录状态设为已完成
- 论文见刊后补上引文
注册库会发提醒邮件,一条挂着不管的记录,落在团队头上不好看。
- **你要产出:**一份已投出的稿件,附清单、流程图、注册编号,以及一条更新过的 PROSPERO 记录。
- **工具:**不需要新工具;参考文献(会很长)由你的文献管理器排版。
- **常见返工原因:**方法部分偏离了已注册协议却不说明——这是审稿人最容易抓到的一件事。紧随其后的是检索过期:Cochrane 要求发表时若初次检索已超过 12 个月就要重跑,所以要预留再筛一轮的时间。
常见问题
系统综述和 meta 分析有什么区别?
系统综述是整个流程:提问、检索、筛选、评价、综合。meta 分析是其中一个可选步骤,把各研究的数值结果合并起来。每一次 meta 分析都应该待在一篇系统综述里面,而很多好综述完全不含 meta 分析。
系统综述要做多久?
我们手上最好的数字来自 PROSPERO 上 195 篇已完成的综述:从注册到论文发表平均 67.3 周(Borah 等,2017)。范围由选题大小决定——那批样本里的检索命中数从 27 条到 9.2 万条以上都有。
一个人能做系统综述吗?
按公认标准不能。筛选、提取和偏倚评估都预期由两个人分开完成。单干会漏研究,还会把一个人的错误固化进去。同一项 2017 年的研究发现,这些综述平均有 5 位作者。
系统综述和文献综述有什么区别?
文献综述总结作者自己挑的来源,没有完整性和可重复的义务。系统综述事先注册规则、尽力找到所有符合条件的研究,并把方法报告到足以被重跑的程度。光有一个看起来很系统的检索并不算——PROSPERO 会把只借用了检索、其余方法都跳过的文献综述排除掉。
一定要在 PROSPERO 注册吗?
没有法律要求,但很多期刊对健康类综述有此预期,而且它能保护你免受"换结局"的质疑。注册必须发生在数据提取开始之前——已经开始提取的综述,注册库不接受。它免费,而且自 2025 年重建以来,所有作者确认后记录即刻发布。