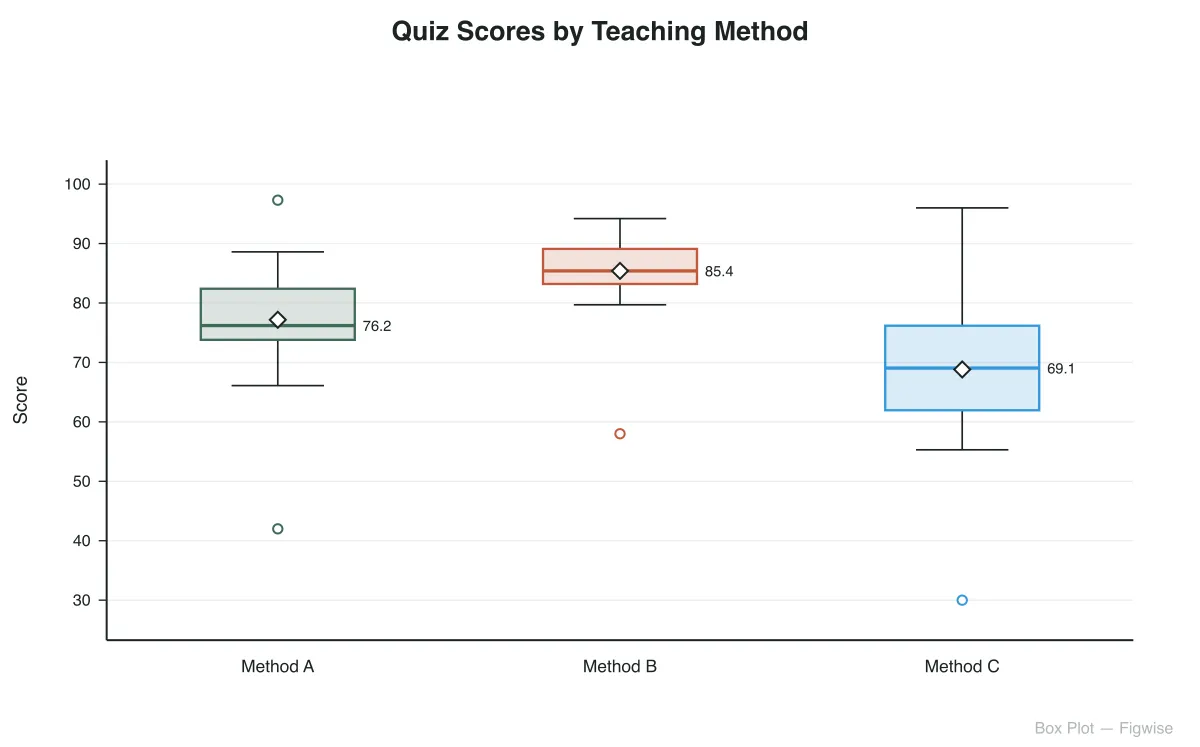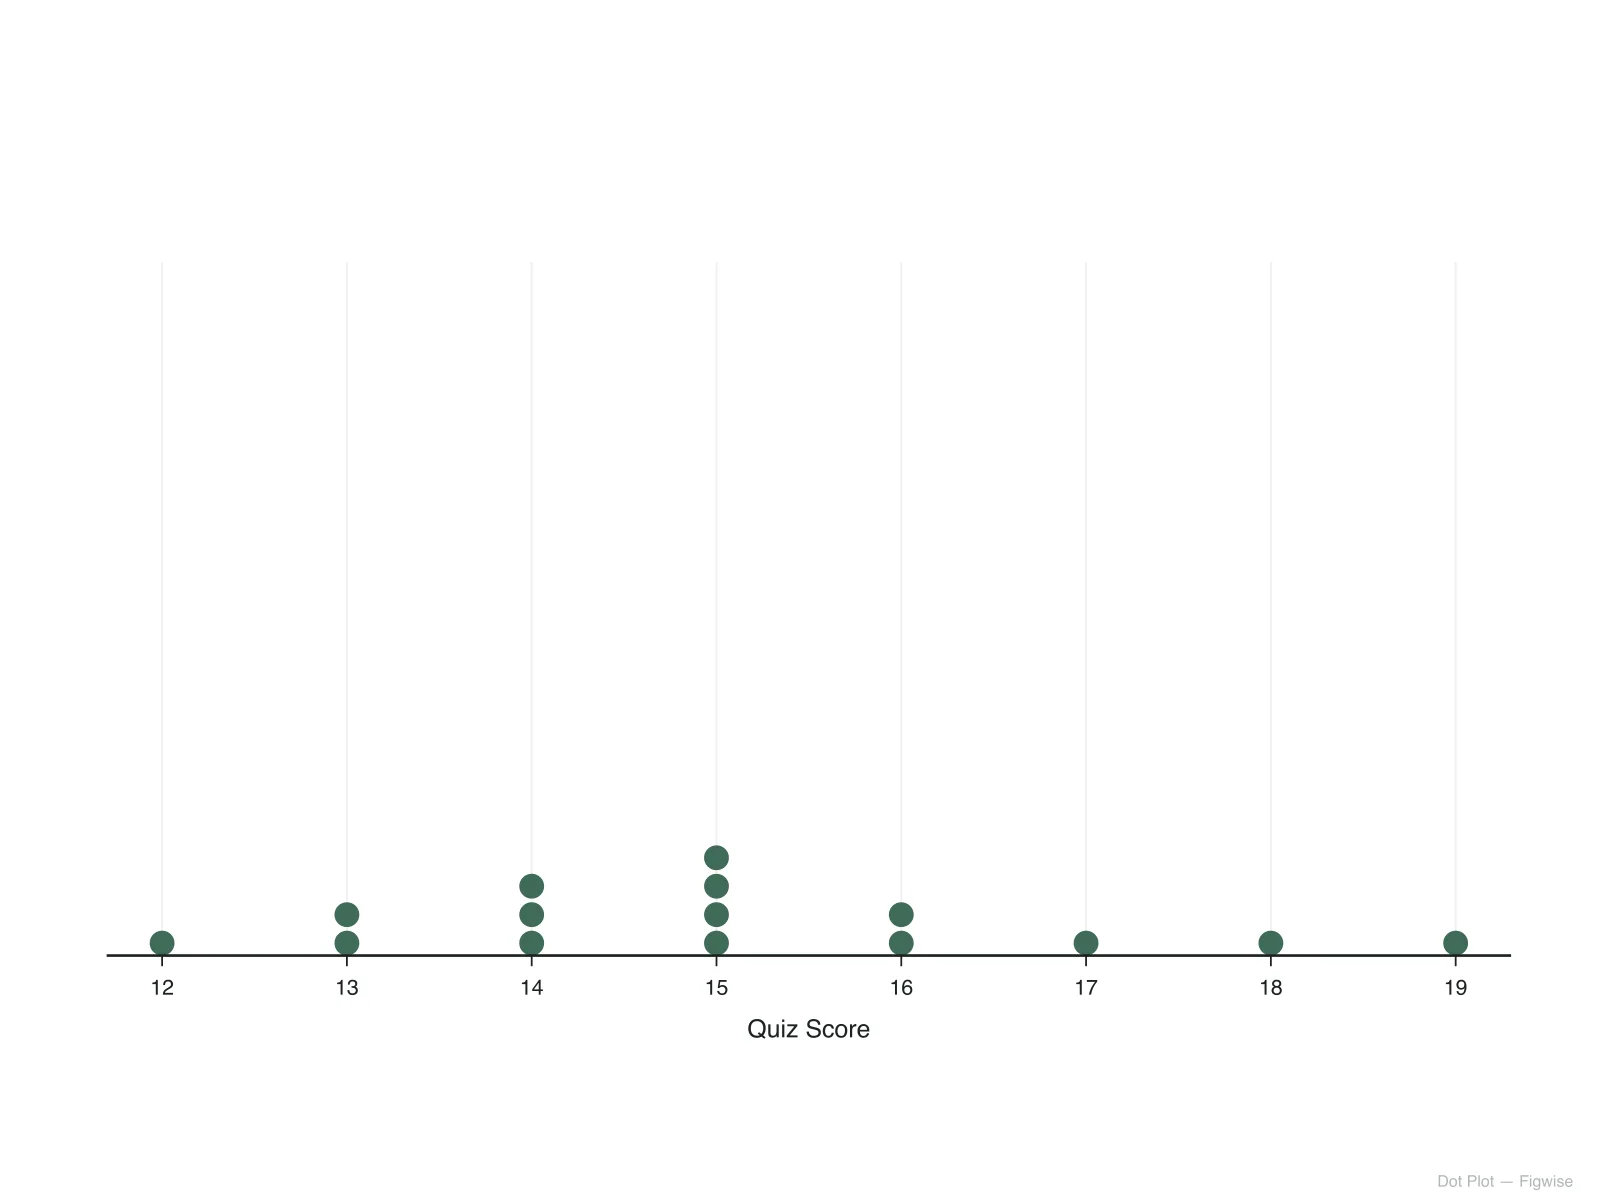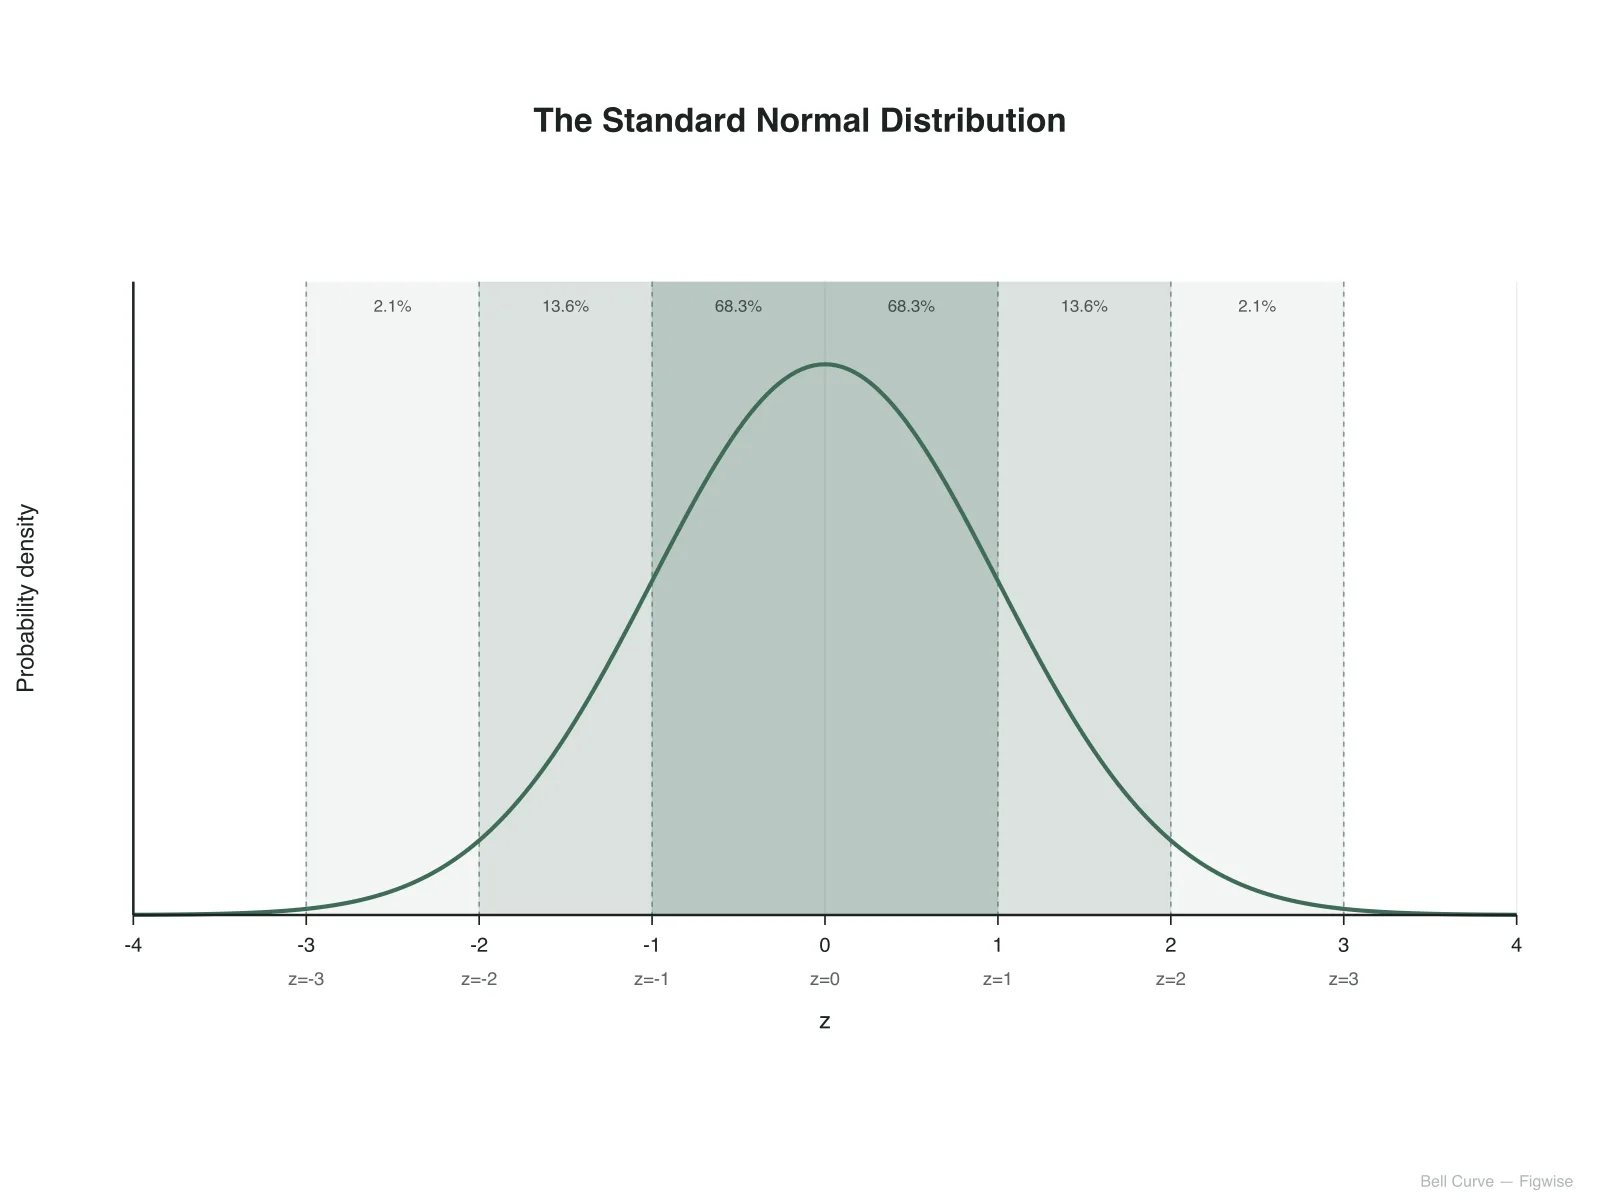
숫자 목록을 붙여넣으면 브라우저에서 바로 구간별 도수분포 히스토그램을 그립니다 — 계급 너비는 자동 또는 직접 지정, y축은 도수와 밀도 중 선택, SVG·PNG 즉시 내보내기.
같은 히스토그램 생성기로 그린 네 가지 분포 — 한 학급의 시험 점수, 반복 측정 오차, 오른쪽으로 꼬리가 긴 대기시간, 봉우리 두 개가 숨어 있는 분포.
학생 33명의 쪽지시험 점수를 Freedman–Diaconis 규칙으로 자동 구간화한 결과. 소수의 낮은 점수가 꼬리를 왼쪽으로 끌어당겨 약한 좌측 비대칭을 보입니다.
같은 물리량을 40번 반복 측정한 결과에 정규분포 곡선을 겹쳐 그리면, 기기 오차가 참값을 중심으로 대체로 대칭적으로 퍼져 있음을 확인할 수 있습니다.
콜센터 대기시간: 대부분은 빨리 연결되지만 일부 지연된 통화가 히스토그램의 오른쪽 꼬리를 길게 늘여, 평균이 중앙값보다 뚜렷이 높아지는 경우입니다.
시작 시간이 다른 두 근무조의 통근시간을 합친 데이터: 계급 너비를 넓히면 두 봉우리가 하나로 뭉개지고, 좁히면 그 아래 숨어 있던 두 번째 집단이 드러납니다.
숫자 목록에서 라벨이 붙은 구간별 도수분포 차트까지, 이 히스토그램 생성기가 각 단계에서 하는 일입니다.
숫자 한 열을 데이터 입력란에 붙여넣습니다. 쉼표, 공백, 줄바꿈 중 무엇으로 구분해도 됩니다. 숫자로 읽히지 않는 항목은 조용히 버려지지 않고 그 자리에서 표시됩니다.
기본 계급 너비는 데이터의 퍼짐 정도와 표본 크기를 바탕으로 Freedman–Diaconis 규칙에 따라 자동 계산됩니다. 딱 떨어지는 간격이 필요하면 숫자를 직접 입력해 덮어쓸 수 있습니다.
각 구간의 원래 도수와, 도수를 계급 너비로 나눈 밀도 사이를 전환할 수 있습니다. 밀도 모드에서는 높이가 아니라 면적끼리 비교할 수 있습니다. 필요하면 정규분포 곡선, 평균선, 중앙값선도 추가하세요.
값이나 계급 너비를 바꿀 때마다 그래프가 다시 그려지고 구간별 집계도 즉시 재계산됩니다. 분포 모양이 원하는 대로 나오면 편집용 SVG나 슬라이드용 PNG로 내보내세요.
히스토그램은 연속형 데이터를 폭이 같은 구간(계급)으로 나눈 뒤, 각 구간에 속한 값의 개수를 높이로 하는 막대를 하나씩 그린 도표입니다. 이 도구는 통계학에서 흔히 쓰이는 왼쪽 닫힘·오른쪽 열림 규칙을 따릅니다: [10, 20) 구간은 10을 포함하지만 20은 포함하지 않고 다음 구간으로 넘어갑니다. 다만 마지막 구간만 양 끝을 모두 닫아 데이터의 최댓값이 반드시 어딘가에 속하도록 합니다. 이 경계 규칙이 중요한 이유는 경계에 정확히 걸친 값이 오직 하나의 구간에만 속해야 하기 때문이며, 이 규칙이 어긋나면 같은 데이터인데도 도구마다 도수가 달라 보이는 흔한 원인이 됩니다.
계급 너비를 정하는 일은 겉모습을 다듬는 문제가 아니라 실제 통계적 결정입니다. 이 생성기는 기본값으로 Freedman–Diaconis 규칙(h = 2 × 사분위범위 × n^(-1/3))을 사용하는데, 전체 범위가 아니라 사분위범위로 퍼짐 정도를 재기 때문에 극단적인 이상치 하나가 계급 전체를 부풀리지 않습니다. 더 오래된 Sturges 규칙은 표본 크기만으로 계급 수를 k = ⌈log2(n) + 1⌉로 정하며 데이터가 정규분포에 가깝다고 암묵적으로 가정하는데, 표본이 크거나 비대칭일수록 계급을 너무 넓게 잡아 실제 구조를 뭉개는 경향이 있습니다. 두 규칙 모두 출발점일 뿐이며, 계급 너비 항목은 언제든 직접 입력해 덮어쓸 수 있습니다.
같은 데이터라도 계급 너비를 조금만 바꾸면 단봉으로 보이던 것이 이봉으로 보이거나, 매끄럽던 것이 들쭉날쭉해 보일 수 있습니다. 좁은 계급 너비는 세부를 드러내지만 표본의 잡음을 가짜 작은 봉우리로 부풀리고, 넓은 계급 너비는 그 잡음을 눌러 주지만 원래 서로 다른 두 집단을 하나의 넓은 봉우리로 뭉개버릴 수도 있습니다. 모든 목적에 맞는 하나의 정답 계급 너비는 없으며, 실용적인 습관은 같은 데이터에 여러 계급 너비를 시험해 보고 나타났다 사라지는 봉우리가 실제 구조를 반영하는지, 아니면 우연히 그 자리에 경계선이 놓였을 뿐인지 따져보는 것입니다.
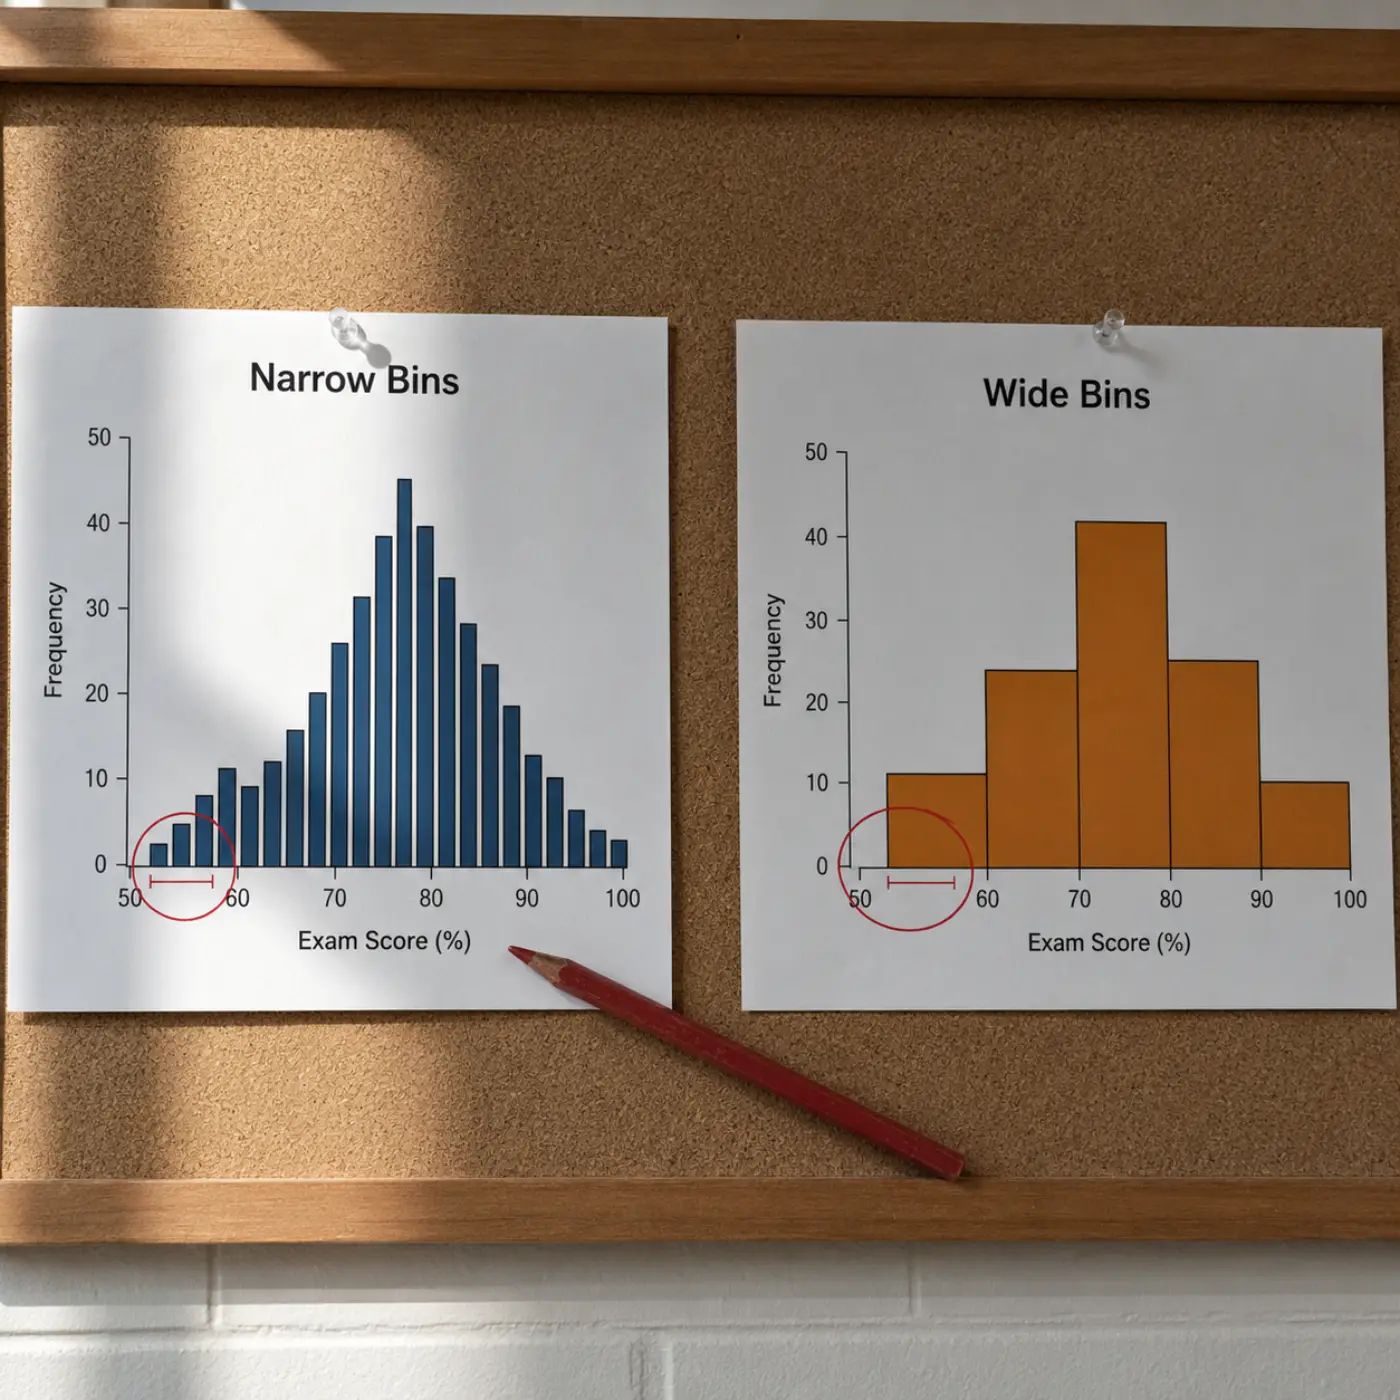
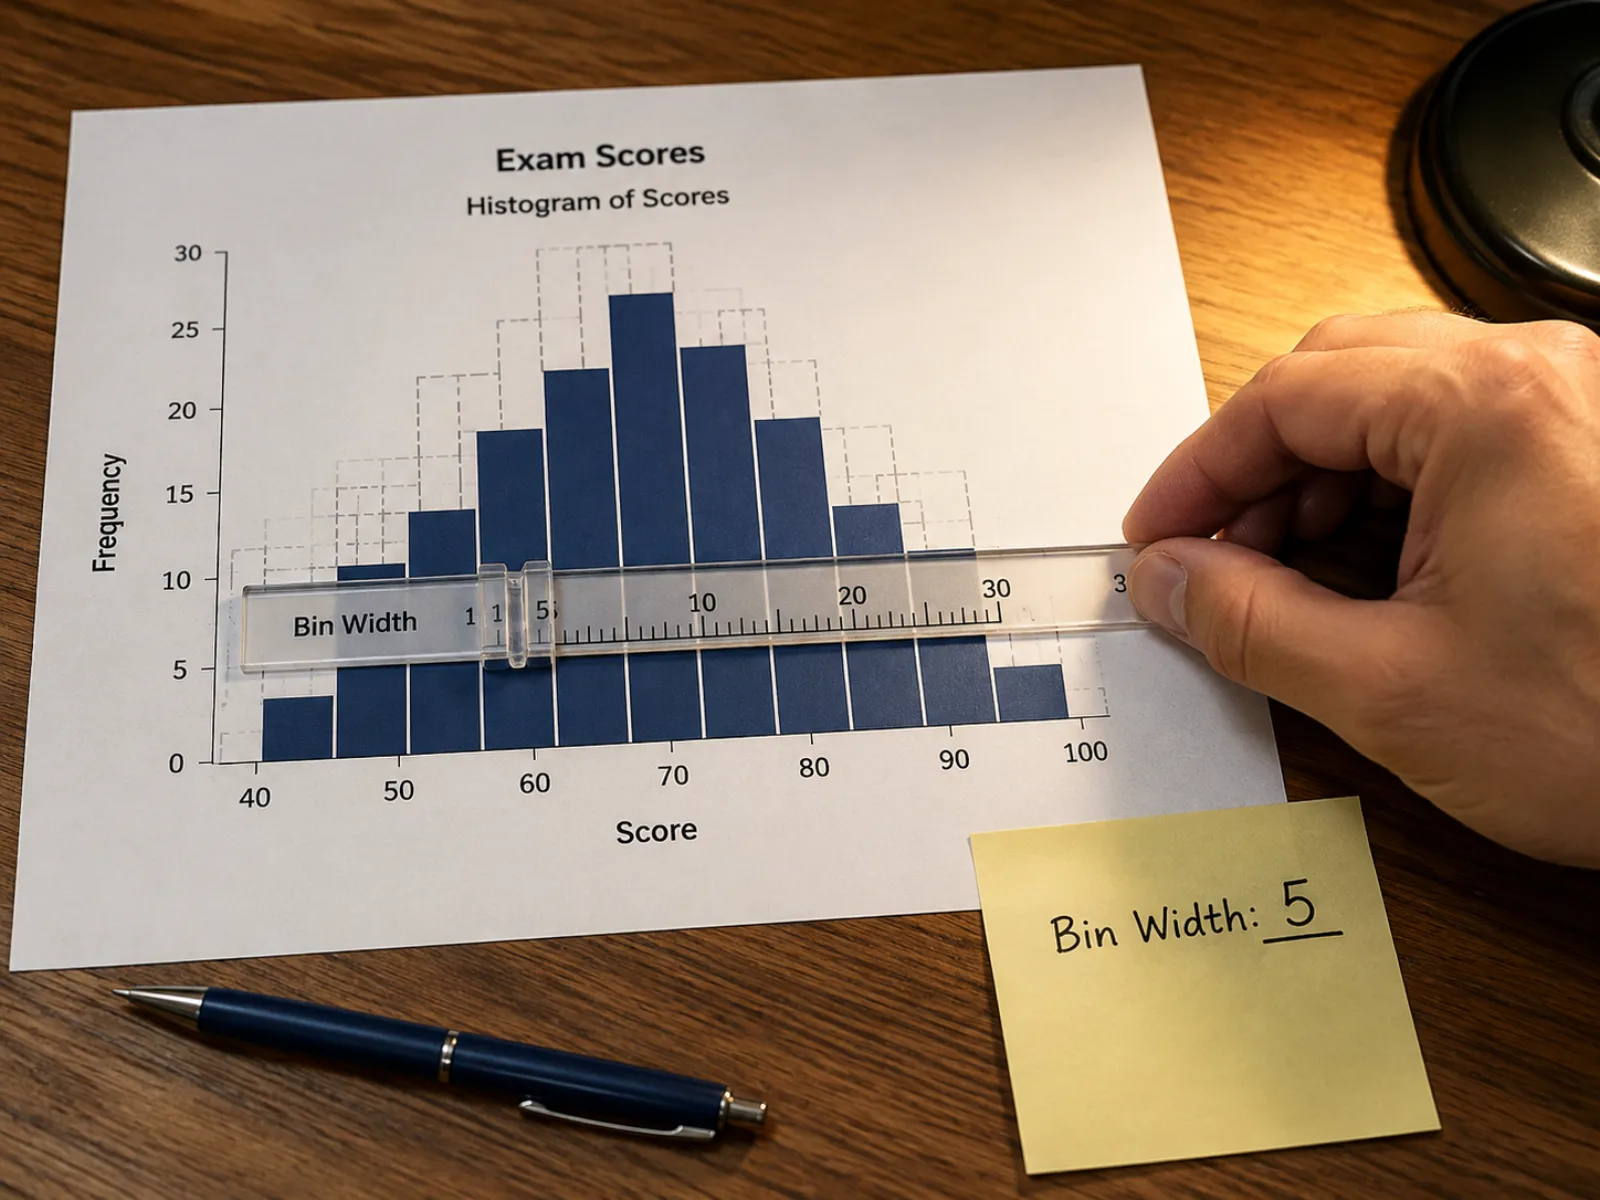
자동 계급 너비는 Freedman–Diaconis 규칙으로 계산되어 표본 크기에 맞게 조정되며, 전체 범위 대신 사분위범위를 사용하므로 이상치 하나가 전체 구간을 왜곡하지 않습니다. 딱 떨어지는 고정 간격이 필요할 때는 언제든 수동 계급 너비로 전환할 수 있습니다.
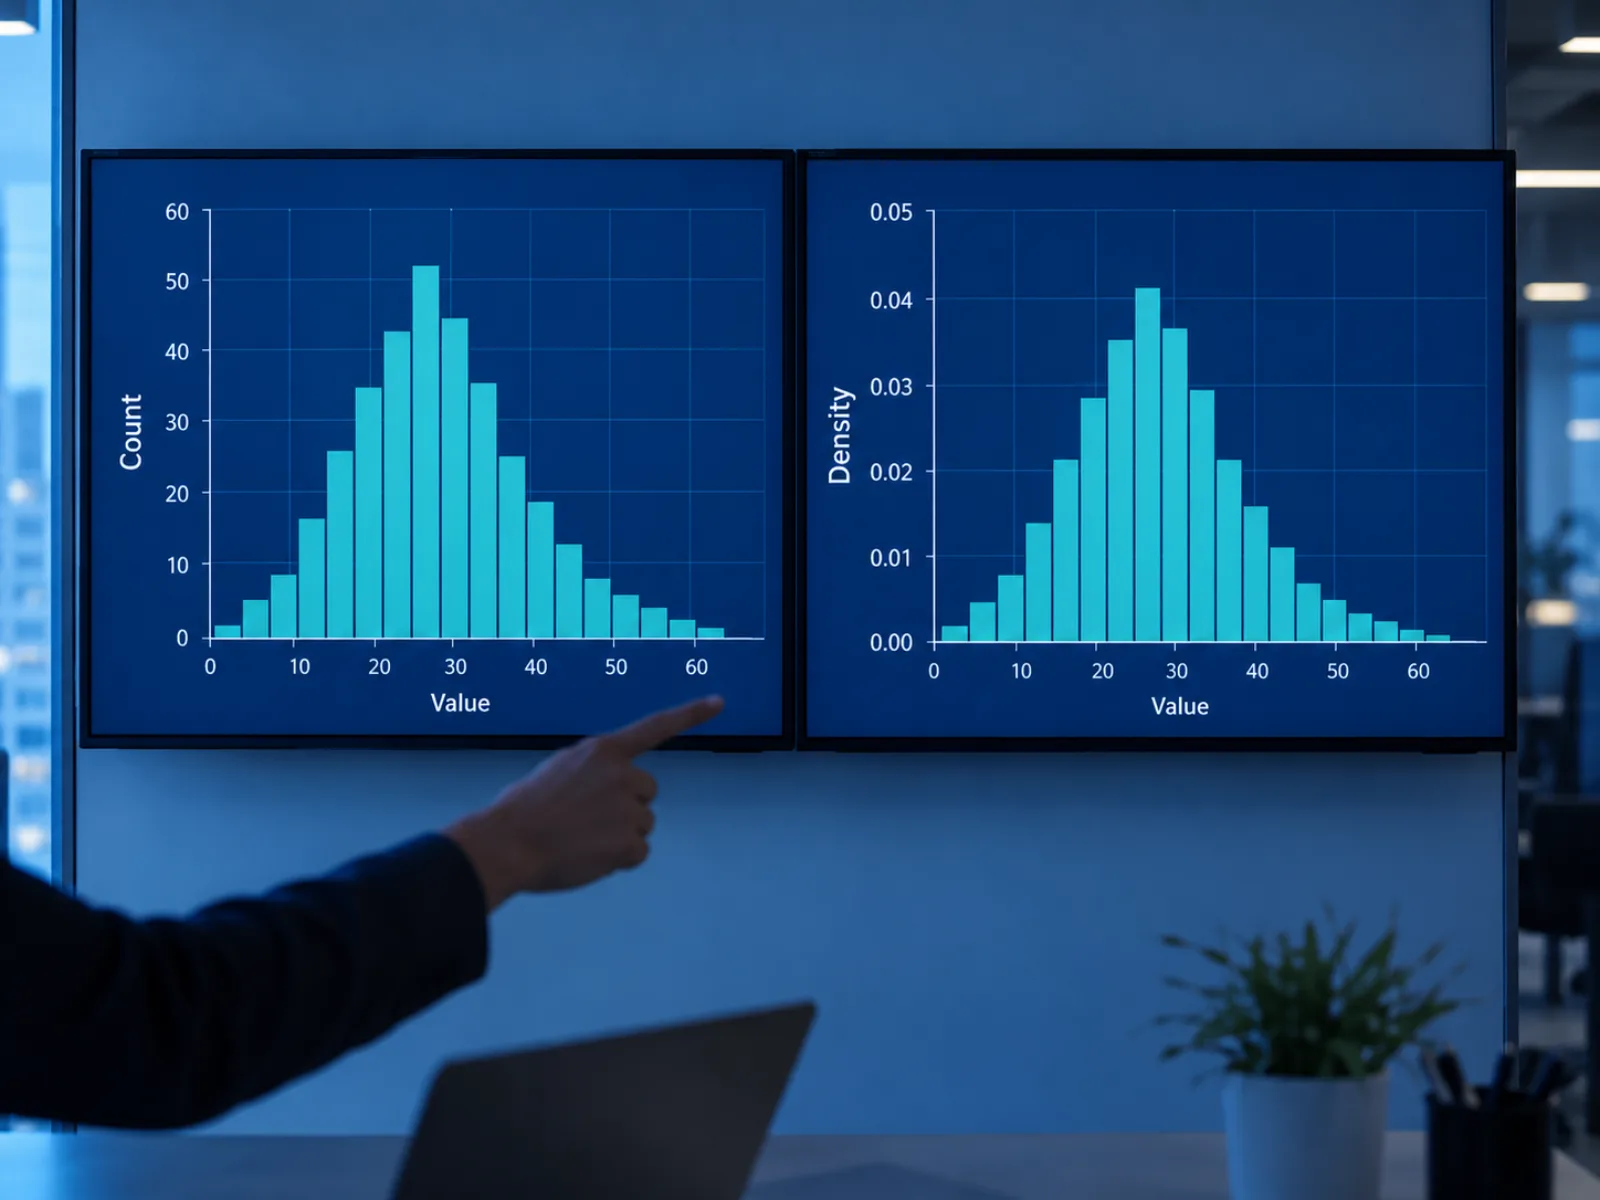
y축을 밀도로 전환하면 각 막대의 높이는 도수를 표본 크기와 계급 너비로 나눈 값이 되어, 모든 막대의 면적을 더하면 정확히 1이 됩니다. 이는 표본을 적합된 확률곡선과 비교할 때 써야 할 축이지, 단순 백분율 눈금이 아닙니다.
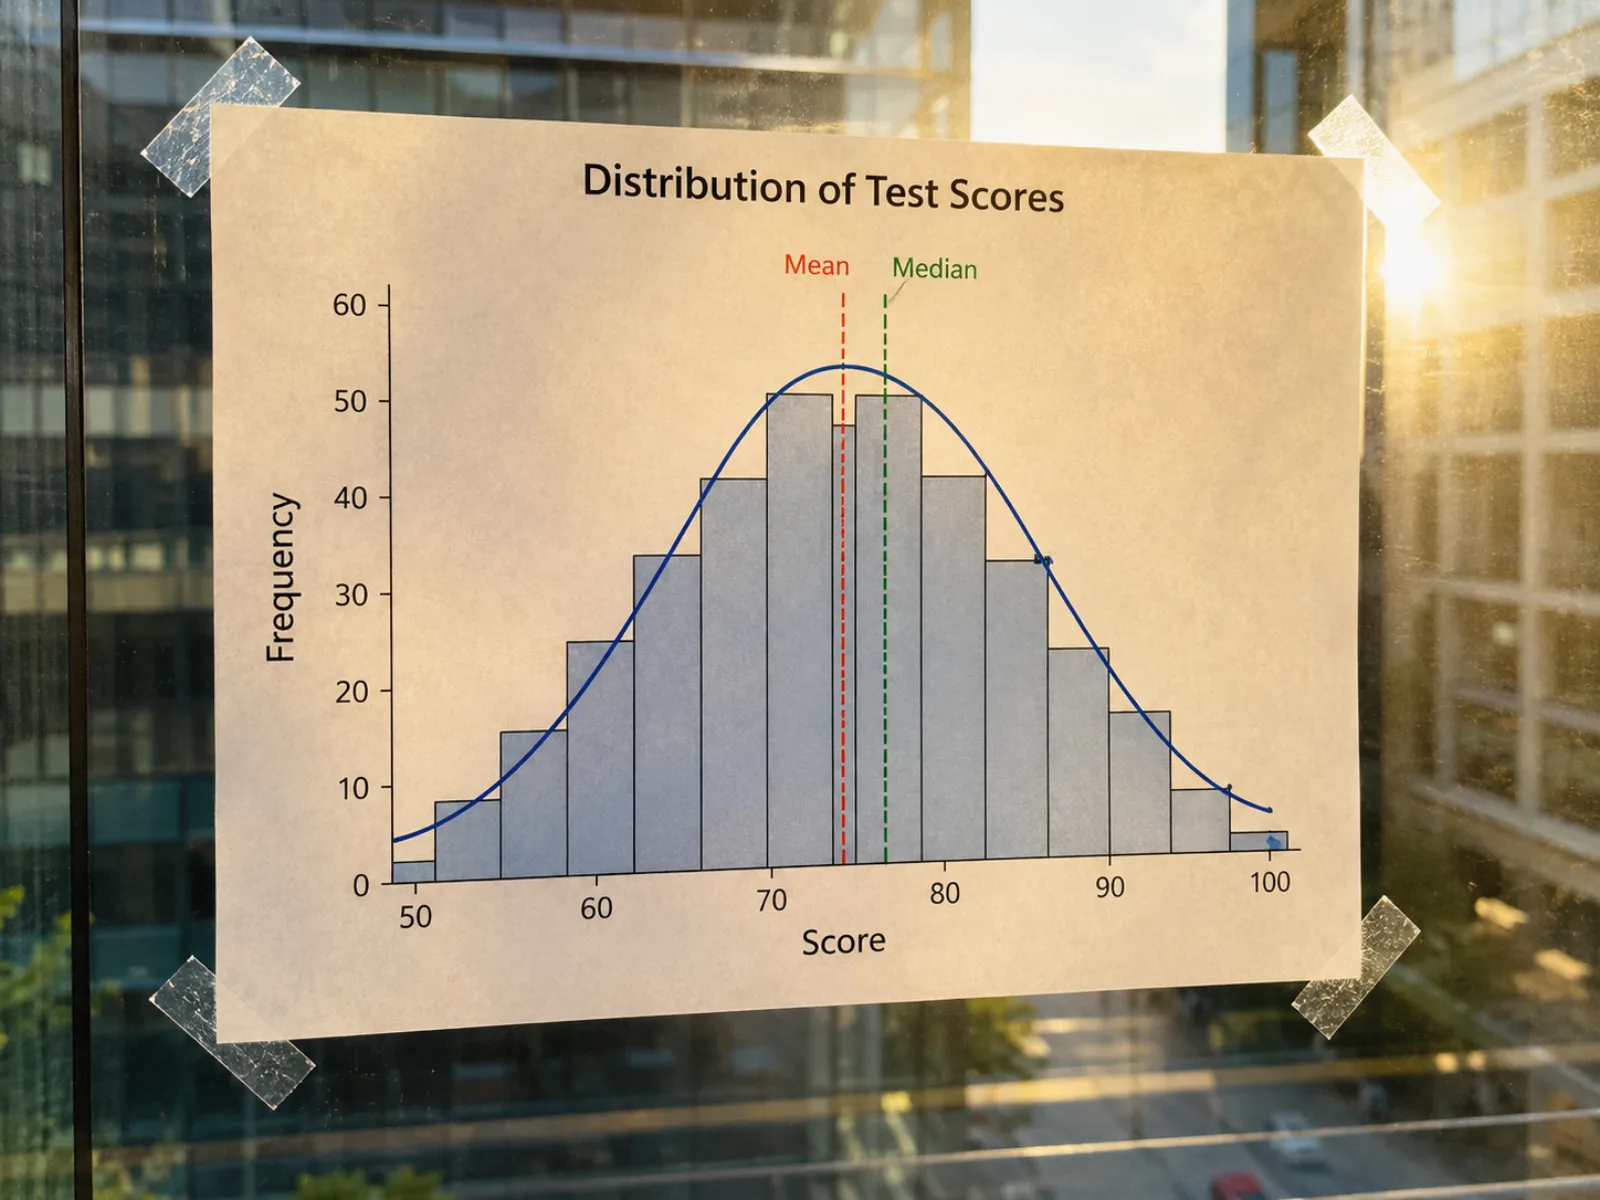
막대 위에 정규분포 곡선을 겹치면 표본이 종형 분포에서 얼마나 벗어나 있는지 한눈에 확인할 수 있고, 평균선과 중앙값선을 추가하면 두 대표값이 일치하는지 아니면 비대칭 때문에 벌어져 있는지 바로 알 수 있습니다.
둘 다 막대로 그려서 자주 혼동되지만, 두 차트는 서로 다른 질문에 답하고 서로 다른 종류의 데이터를 다룹니다. 한쪽을 다른 쪽 대신 쓰면 가로축이 실제로 의미하는 바를 잘못 전달하게 됩니다.
하나의 연속형 변수를 구간으로 나눠서 그립니다
이산적이고 이름이 붙은 범주를 그립니다, 구간화가 필요 없습니다
처음 히스토그램을 만들기 전후로 가장 자주 나오는 질문들입니다.
숫자 목록을 이 히스토그램 생성기에 붙여넣고 계급 너비를 조정한 뒤, 보고서나 발표 슬라이드에 바로 쓸 수 있는 그래프를 내려받으세요.