 Team Figwise
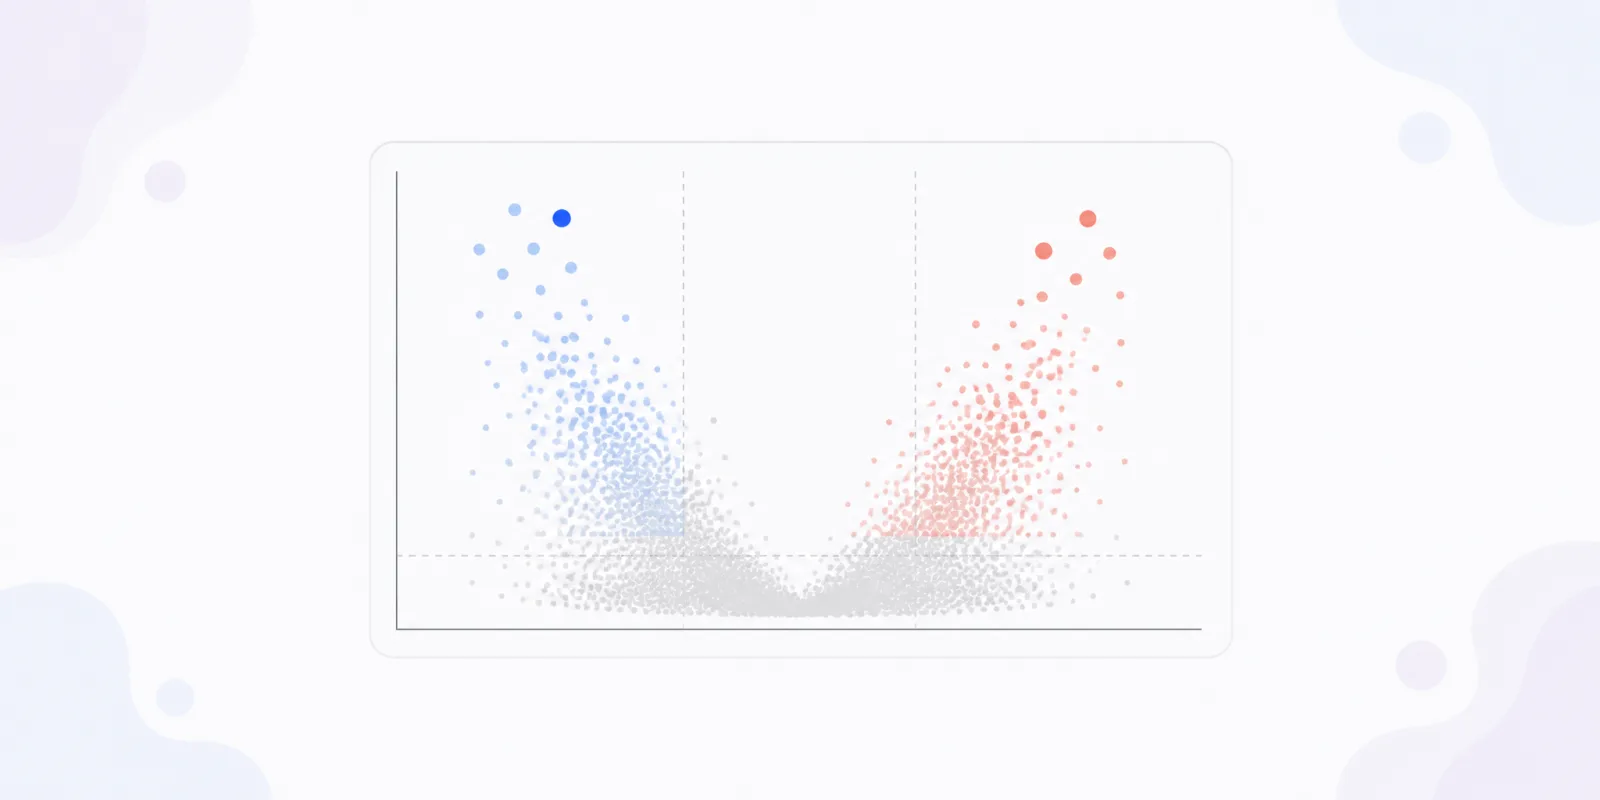
Un volcano plot riunisce ogni gene di un singolo test di espressione differenziale in un unico pannello. L'asse x è il log2 fold change. L'asse y è −log10 del valore p corretto. I geni lontani dal centro e in alto sono i tuoi candidati.
Per creare il grafico servono dieci righe di codice. Leggerlo correttamente richiede più attenzione. Le due linee tratteggiate che la maggior parte delle persone copia, |log2FC| ≥ 1 e padj < 0.05, sono un'abitudine grafica, non una regola — e la guida per utenti di edgeR afferma che usare quella coppia per selezionare i geni «distruggerà in generale il controllo dell'FDR» (sezione 2.14).
Questo articolo spiega cosa significa ciascun asse, quale soglia tracciare e perché, come leggere ogni regione della nuvola e include codice R e Python funzionante. Se ti serve solo il diagramma, il nostro volcano plot generator prende una tabella di risultati e restituisce un grafico etichettato.
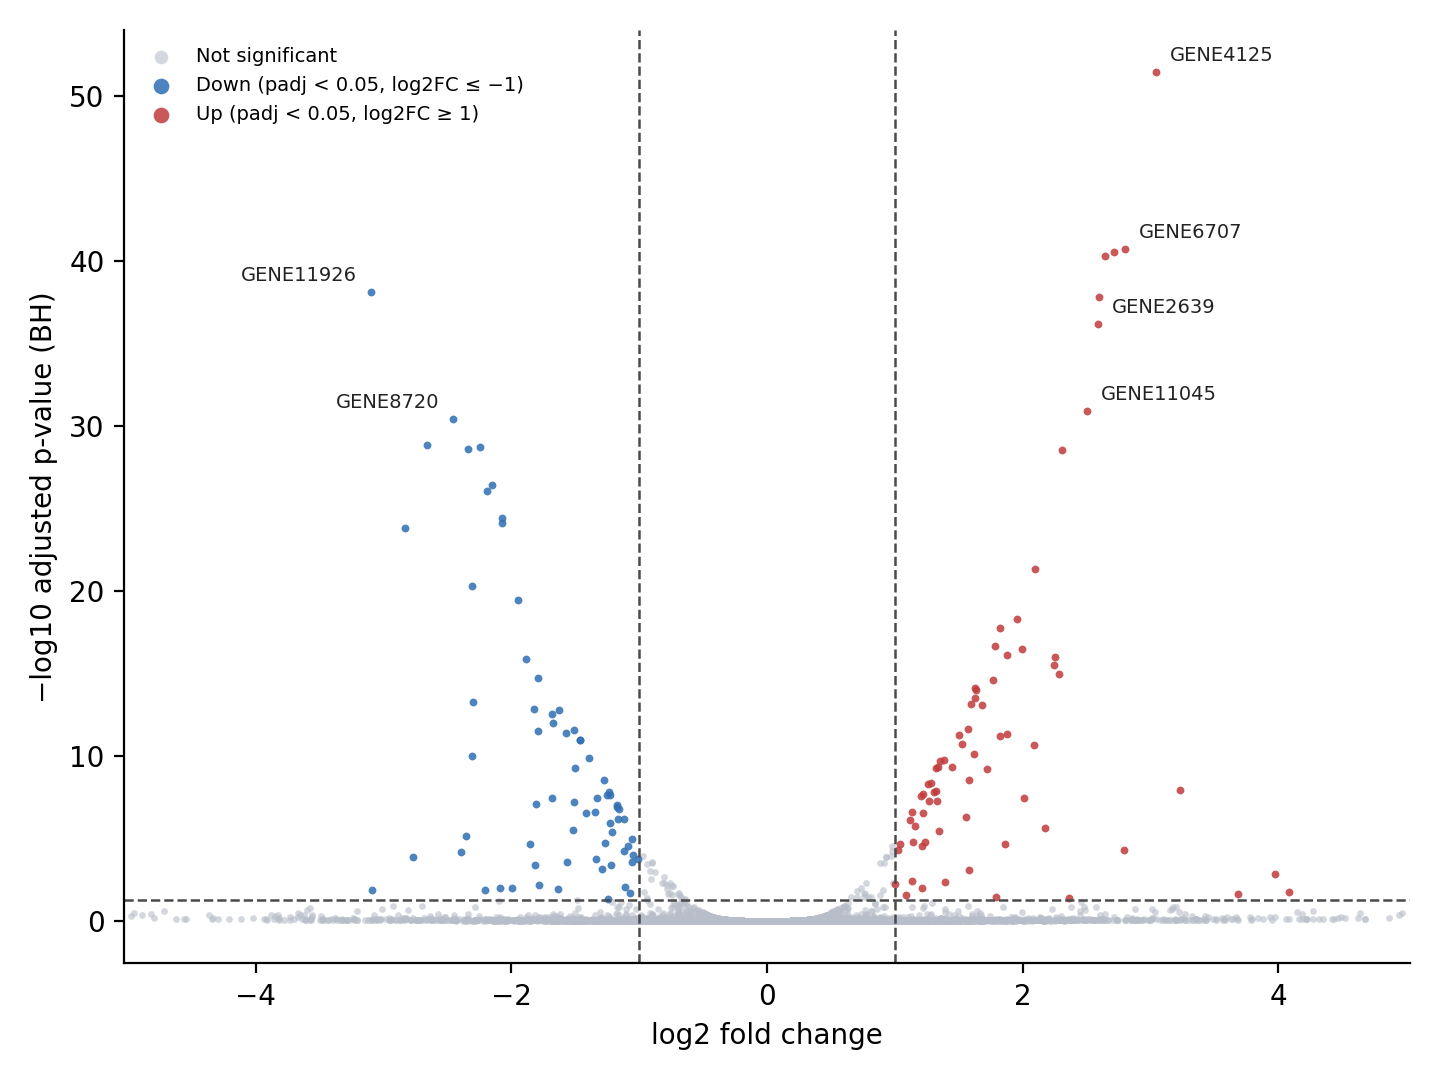
Volcano plot da dati simulati (12,000 geni, 5% con un effetto reale). Realizzato con matplotlib; il codice che ha generato i dati è nella sezione Python qui sotto e lo script completo per la creazione del grafico si trova accanto a questa immagine nel repository.
I due assi e perché entrambi sono in scala logaritmica
Entrambi gli assi sono in scala logaritmica per la stessa ragione: le scale grezze nascondono la parte che ti interessa.
Il fold change su una scala grezza è sbilanciato. Un gene che raddoppia assume 2.0 e uno che si dimezza assume 0.5, quindi l'aumento ha spazio fino all'infinito mentre la diminuzione è compressa sotto 1. Il log2 risolve il problema: il raddoppio diventa +1, il dimezzamento −1 e i due lati del grafico sono immagini speculari.
I valori p sono il problema opposto. Si accumulano vicino a zero, dove si trovano tutti quelli interessanti. Applicare −log10 distribuisce quella massa e il segno meno porta in alto l'evidenza più forte.
| padj | −log10(padj) | Posizione |
|---|---|---|
| 0.05 | 1.3 | la solita linea tratteggiata |
| 0.01 | 2.0 | appena sopra |
| 1e-10 | 10 | chiaramente nel cono |
| 1e-50 | 50 | vicino al limite superiore |
Da quella tabella seguono due fatti. Un punto a y = 4 ha un padj cento volte più piccolo di un punto a y = 2. E l'asse y non ha un limite superiore, quindi un gene con un valore p minuscolo può allungare l'intero grafico.
Metti padj sull'asse y, non il valore p grezzo
Con i valori p grezzi sull'asse y otterrai centinaia di falsi risultati positivi. La RNA-seq bulk testa ogni gene, quindi un'analisi con 15,000 geni testati e nessun effetto reale dà comunque circa 750 geni a p < 0.05.
La soluzione è una correzione del tasso di false scoperte. Il metodo di Benjamini-Hochberg riscala i valori p, così una soglia di 0.05 significa «circa il 5% dei geni che conservo è falso», non «il 5% di tutti i test». R lo fa in p.adjust con method = "BH", come descritto da Benjamini and Hochberg (1995).
Entrambi i principali strumenti ti forniscono già la colonna corretta:
- DESeq2 (vignetta):
log2FoldChange,pvalue,padj. La colonnapadjusa BH per impostazione predefinita, perchéresults()viene eseguita conpAdjustMethod = "BH". - edgeR (guida per utenti):
topTags()restituiscelogFC,logCPM, una colonna della statistica del test (FoLR),PValueeFDR. La colonna da usare èFDR.
Due dettagli di DESeq2 causano spesso problemi. Primo, results() usa alpha = 0.1 per impostazione predefinita e il suo passaggio di filtraggio indipendente è calibrato su quel valore. Se la linea tratteggiata è a 0.05, chiama results(dds, alpha = 0.05) in modo che il filtraggio corrisponda alla linea tracciata.
Secondo, alcuni geni tornano con padj = NA. Sono il filtraggio indipendente e la rimozione degli outlier a fare il loro lavoro, come spiegato nella sezione della vignetta «Perché alcuni valori p sono impostati su NA?». Elimina queste righe prima di creare il grafico. Non trasformare mai NA in 1 o 0.
Dove tracciare le linee di soglia
Non esiste una coppia di soglie standard, solo coppie comuni. Ecco da dove derivano effettivamente i numeri più usati:
| Coppia di soglie | Fonte | Adatta quando |
|---|---|---|
| padj < 0.05, |log2FC| ≥ 1 (2-fold) | convenzione, nessuna fonte primaria | molti geni DE, buona replicazione |
| FDR < 0.01, |log2FC| ≥ 0.58 (1.5-fold) | tutorial di formazione Galaxy | segnale forte, soglia più stretta sul valore p che sull'entità |
FDR < 0.05, fold change sopra 1.2, testato con glmTreat |
guida per utenti di edgeR, sezione 4.4 | migliaia di risultati da restringere |
| padj < 0.1, nessuna linea del fold change | valore predefinito di alpha di DESeq2 |
n piccolo, screening esplorativo |
Scegli in base alla quantità di segnale che hai, non all'abitudine. Se 6,000 geni superano la soglia, l'elenco è inutile e un limite più alto sul fold change aiuta. Se passano nove geni, elimina la linea del fold change e ordina invece per padj.
La guida di edgeR offre la regola più utile in una riga per la soglia sull'asse x. Interpretala come «il fold change al di sotto del quale non siamo assolutamente interessati al gene», non come la variazione al di sopra della quale un gene diventa interessante.
La trappola delle soglie da conoscere
Filtrare prima per p e poi per fold change non è un test valido. La guida di edgeR è netta al riguardo: combinazioni di questo tipo «sono entrambe ad hoc e non forniscono valori p significativi per testare le espressioni differenziali rispetto a una soglia di fold change». «Favoriscono geni con bassa espressione ma altamente variabili» e «distruggono in generale il controllo dell'FDR».
Se la barra del fold change è importante per la tua conclusione, esegui il test rispetto a essa invece di filtrare a posteriori:
# DESeq2: test whether |log2FC| is above 1, not just above 0
res <- results(dds, lfcThreshold = 1, altHypothesis = "greaterAbs", alpha = 0.05)

# edgeR: same idea, via the TREAT method
fit <- glmQLFit(y, design)
tr  <- glmTreat(fit, coef = 2, lfc = 1)
Ora padj tiene già conto della soglia dimensionale e le linee verticali descrivono il test che hai eseguito. Entrambe le opzioni sono documentate: consulta i test del log2 fold change sopra una soglia in DESeq2 e l'articolo su TREAT alla base di glmTreat.
Come leggere il grafico, regione per regione
Leggi la nuvola prima delle etichette. La forma dice più sull'esperimento di qualsiasi singolo gene.
| Regione | Cosa significa | Cosa fare |
|---|---|---|
| In alto a destra, in alto a sinistra | Grande variazione, evidenza forte | il tuo elenco di candidati |
| Centro superiore (y alto, |log2FC| < 0.3) | Variazione piccola, misurata molto bene | controlla di quale gene si tratta |
| Bordi inferiori (|log2FC| > 2, y vicino a 0) | Rapporto grande, evidenza debole | non inseguirli |
| Banda larga e piatta, nulla sopra la linea | Poco o nessun segnale | torna al controllo di qualità |
Centro superiore è la regione che viene interpretata male più spesso. Questi geni sono solitamente geni con conteggi elevati, per i quali l'errore standard è piccolo, quindi anche una variazione del 15% supera la soglia del valore p. La variazione è reale, ma stabilire se una variazione del 15% sia importante è una questione biologica, non statistica. Un segnale d'allarme: se lì si trovano geni housekeeping o ribosomiali, sospetta un problema di normalizzazione o di composizione delle librerie, non la biologia.
Bordi inferiori sono l'immagine speculare. Un gene con 4 conteggi in un gruppo e 30 nell'altro produce un log2 fold change enorme e quasi nessuna evidenza. Questi punti allargano l'asse x e rendono la storia più interessante, e raramente replicano. La contrazione dei fold change corregge la visualizzazione: lfcShrink(dds, coef = 2, type = "apeglm") porta i geni misurati male verso zero e lascia invariati quelli misurati bene.
Due controlli della forma completano la lettura:
- Simmetria. Una nuvola sbilanciata, per esempio con 900 geni up e 40 down, può indicare una vera attivazione. Può anche derivare da uno spostamento della composizione che la normalizzazione non ha assorbito. Controlla il grafico MA e i fattori di dimensione prima di scrivere quella frase.
- Larghezza della V. Lo spazio vuoto intorno a x = 0, con punti che salgono su entrambi i fianchi, è previsto, perché le variazioni più grandi superano più facilmente la soglia del valore p. Un picco verticale compatto su x = 0, invece, di solito significa che hai rappresentato valori p grezzi.
Crea il grafico in R dai risultati di DESeq2
Questo codice funziona con un DESeqDataSet chiamato dds e richiede ggplot2, ggrepel e dplyr.
library(DESeq2)
library(ggplot2)
library(ggrepel)
library(dplyr)

lfc_cut  <- 1
padj_cut <- 0.05

# keep alpha equal to the line you draw, or filtering optimises for 0.1
res <- results(dds, alpha = padj_cut)

df <- as.data.frame(res)
df$gene <- rownames(df)
df <- df[!is.na(df$padj), ]
df$padj <- pmax(df$padj, .Machine$double.xmin)  # padj can underflow to 0

df$class <- "Not significant"
df$class[df$padj < padj_cut & df$log2FoldChange >=  lfc_cut] <- "Up"
df$class[df$padj < padj_cut & df$log2FoldChange <= -lfc_cut] <- "Down"

top <- df %>%
  filter(class != "Not significant") %>%
  arrange(padj) %>%
  slice_head(n = 10)

ggplot(df, aes(x = log2FoldChange, y = -log10(padj), colour = class)) +
  geom_point(size = 1, alpha = 0.7) +
  geom_hline(yintercept = -log10(padj_cut), linetype = "dashed") +
  geom_vline(xintercept = c(-lfc_cut, lfc_cut), linetype = "dashed") +
  geom_text_repel(
    data = top, aes(label = gene),
    colour = "black", size = 3, max.overlaps = Inf, show.legend = FALSE
  ) +
  scale_colour_manual(values = c(
    "Up" = "#c23b3b", "Down" = "#2f6fb2", "Not significant" = "#b8bec9"
  )) +
  coord_cartesian(xlim = c(-5, 5)) +
  labs(x = "log2 fold change", y = "-log10 padj", colour = NULL) +
  theme_classic()
Provenendo da edgeR, rinomina due colonne e il resto dello script funziona:
df <- topTags(qlf, n = Inf)$table
df$log2FoldChange <- df$logFC
df$padj <- df$FDR
Per una versione completamente rifinita con connettori e riquadri ombreggiati per le soglie, vale la pena leggere la vignetta di EnhancedVolcano.
Crea il grafico in Python da un DataFrame pandas
Esporta la tabella di DESeq2 in CSV, poi esegui questo codice. Usa soltanto pandas, numpy e matplotlib.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# first column is the gene name; needs DESeq2's log2FoldChange and padj
df = pd.read_csv("deseq2_results.csv", index_col=0)
df = df.dropna(subset=["padj", "log2FoldChange"]).copy()

lfc_cut, padj_cut = 1.0, 0.05

# padj can underflow to 0, which makes -log10 infinite; clip it first
df["y"] = -np.log10(df["padj"].clip(lower=np.finfo(float).tiny))
df["cls"] = "not significant"
df.loc[(df["padj"] < padj_cut) & (df["log2FoldChange"] >= lfc_cut), "cls"] = "up"
df.loc[(df["padj"] < padj_cut) & (df["log2FoldChange"] <= -lfc_cut), "cls"] = "down"

colours = {"not significant": "#b8bec9", "down": "#2f6fb2", "up": "#c23b3b"}
fig, ax = plt.subplots(figsize=(7, 5), dpi=200)
for name, grp in df.groupby("cls"):
    ax.scatter(grp["log2FoldChange"], grp["y"], s=6, c=colours[name],
               label=name, alpha=0.7, linewidths=0)

ax.axhline(-np.log10(padj_cut), ls="--", lw=0.9, c="#444444")
for v in (-lfc_cut, lfc_cut):
    ax.axvline(v, ls="--", lw=0.9, c="#444444")

top = df[df["cls"] != "not significant"].nsmallest(10, "padj")
for gene, row in top.iterrows():
    ax.annotate(gene, (row["log2FoldChange"], row["y"]), xytext=(4, 4),
                textcoords="offset points", fontsize=7)

ax.set_xlabel("log2 fold change")
ax.set_ylabel("-log10 padj")
ax.set_xlim(-5, 5)
ax.legend(frameon=False, markerscale=2)
fig.tight_layout()
fig.savefig("volcano.png")
Lavorando dall'output edgeR in Python, rinomina prima logFC in log2FoldChange e FDR in padj.
Il codice dietro al diagramma sopra
Il diagramma di esempio usa dati simulati, non un dataset reale. Il modello è volutamente semplice: le medie di base sono distribuite su quattro ordini di grandezza, il 5% dei geni presenta un effetto reale e l'errore standard cresce al diminuire della media di base. È quest'ultimo aspetto a creare i punti con poca evidenza ai bordi estremi.
import numpy as np
from math import erfc

rng = np.random.default_rng(11)
n = 12000

base_mean = 10 ** rng.uniform(0, 4.2, n)
true_lfc = np.where(rng.random(n) < 0.05, rng.normal(0, 1.1, n), 0.0)
se = np.sqrt(0.035 + 9.0 / base_mean)        # low-count genes get a larger standard error
lfc = true_lfc + rng.normal(0, se)
pval = np.array([erfc(abs(s) / np.sqrt(2)) for s in lfc / se])

# Benjamini-Hochberg, same as R's p.adjust(method = "BH")
order = np.argsort(pval)
ranked = pval[order] * n / np.arange(1, n + 1)
padj = np.empty(n)
padj[order] = np.clip(np.minimum.accumulate(ranked[::-1])[::-1], 0, 1)
padj[base_mean < 1.5] = np.nan                # stand-in for independent filtering
Cinque errori che rendono fuorviante un volcano plot
- Valori p grezzi sull'asse y. Centinaia di geni superano la linea per caso. Usa
padjoFDRe specifica quale dei due usi nell'etichetta dell'asse. - Trattare la linea del fold change come significato biologico. Una variazione di 2 volte in un fattore di trascrizione e in una proteina strutturale non sono affermazioni comparabili. La linea è un filtro, non un'evidenza.
- Lasciare che gli outlier allarghino gli assi. Un gene a log2FC = 12 appiattisce tutto il resto. Limita la visualizzazione con
coord_cartesian()oset_xlim()e indica i punti tagliati con triangoli sul bordo invece di eliminarli. - Colorare solo in base al fold change. Il rosso per ogni gene oltre x = 1 contrassegna come risultati positivi geni rumorosi con pochi conteggi. Il colore deve dipendere da entrambe le condizioni: oltre la linea del fold change e oltre la linea del padj.
- Nessuna linea tratteggiata. Senza di esse il lettore non può distinguere la tua soglia dal grafico. Disegnale entrambe e inserisci i numeri nella didascalia o nella legenda.
FAQ
Un volcano plot è la stessa cosa di un grafico MA?
No, rispondono a domande diverse. Un grafico MA mette l'espressione media sull'asse x e il log2 fold change sull'asse y, quindi mostra se le variazioni più grandi provengono da geni con pochi conteggi. Un volcano plot elimina il livello di espressione e mostra invece l'evidenza. Crea entrambi durante il lavoro, pubblica il volcano plot.
Cosa faccio quando padj è esattamente 0?
È un underflow in virgola mobile, non un valore p pari a zero. -log10(0) dà infinito e il punto scompare o rompe l'asse. Limita padj al più piccolo double positivo prima del logaritmo, come nel codice Python sopra, e riporta il gene nel testo come padj < 1e-300.
Quanti geni dovrei etichettare?
Da dieci a venti sono leggibili; di più diventano un pasticcio. Ordina per padj tra i geni che superano anche la linea del fold change, poi etichetta un numero fisso. Usa ggrepel in R o chiamate annotate con spostamento in Python, così il testo non si sovrappone ai punti. Etichetta ogni gene che nomini nell'abstract, anche se non è tra i primi dieci.
Un volcano plot può finire direttamente in un articolo?
Sì, se viene esportato come grafica vettoriale o alla risoluzione richiesta dalla rivista e se l'analisi sottostante è riproducibile. Gli editori trattano i diagrammi di dati in modo diverso dalle illustrazioni e le regole vanno verificate prima dell'invio — consulta la nostra guida alle politiche delle riviste sui diagrammi generati dall'IA. Per il pannello riassuntivo di un articolo, un graphical abstract maker copre la parte schematica, mentre il volcano plot resta un grafico basato sui tuoi numeri.